

Миграция и сохранение структуры ядра
Вкладка «Миграция» позволяет безопасно обновлять структуру проекта, когда выполняется полная кластеризация семантического ядра. Создание слепка миграции сохраняет накопленную историю позиций, снимки видимости, анализы топа и пользовательские метки на кластерах, чтобы после изменения алгоритма перенести их на новые группы в один клик.
Вкладка «Миграция» и создание слепка
При полной кластеризации проекта существующие группы удаляются и формируются заново. При этом история позиций по отдельным поисковым запросам никуда не удаляется и сохраняется непрерывно (до 5 лет). Удаляются именно производные данные уровня кластеров: агрегированные графики видимости групп, SERP-слепки видимости по кластерам, результаты SEO-анализа и пользовательские метки. Чтобы не потерять этот кластерный контекст, перед запуском полной кластеризации создаётся слепок текущей структуры.
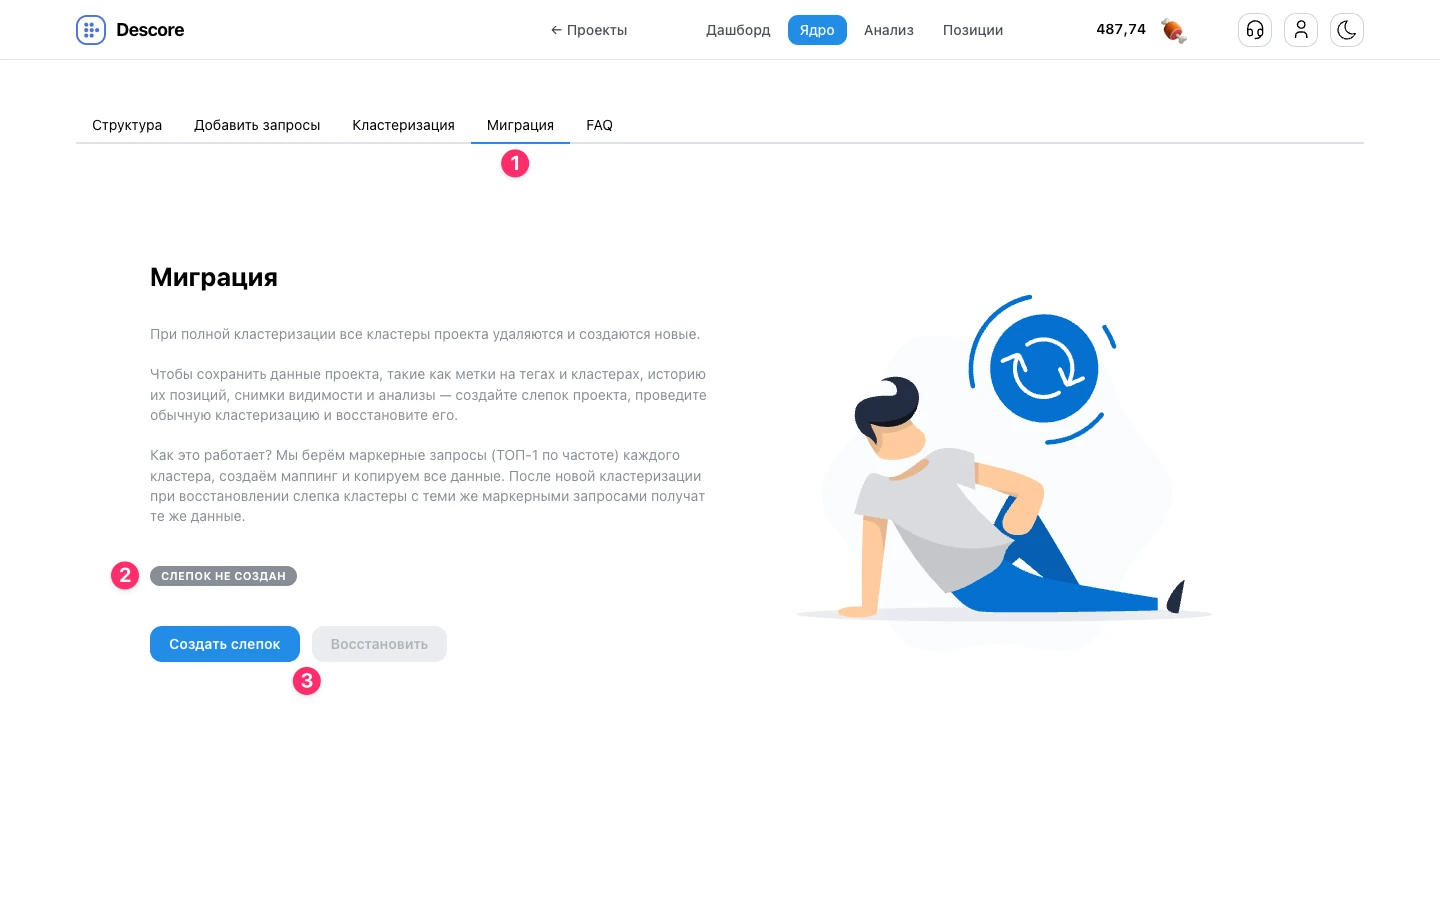
- 1 Вкладка «Миграция» — расположена в верхнем меню модуля «Ядро» рядом с разделами «Структура», «Добавить запросы» и «Кластеризация». В новом проекте с 0 кластеров здесь отображается информационная заглушка с предложением вернуться после первой кластеризации.
- 2 Индикатор статуса — бейдж СЛЕПОК НЕ СОЗДАН указывает на отсутствие сохранённого слепка проекта.
- 3 Кнопка «Создать слепок» — открывает модальное окно расчёта лимитов и подтверждения запуска. Кнопка «Восстановить» остаётся неактивной до создания первого слепка.
Принцип маркерных запросов: в качестве якорного запроса кластера фиксируется вручную назначенный главный запрос (если он был задан в настройках кластера) либо самый частотный запрос (ТОП-1 Wordstat). Сопоставление выполняется по постоянному идентификатору запроса: после перекластеризации новые группы, содержащие этот якорный запрос, получают обратно сохранённую историю позиций, анализы и метки.
Параметры и создание слепка
При нажатии на кнопку «Создать слепок» открывается диалоговое окно с параметрами операции и расчётом списания лимитов.
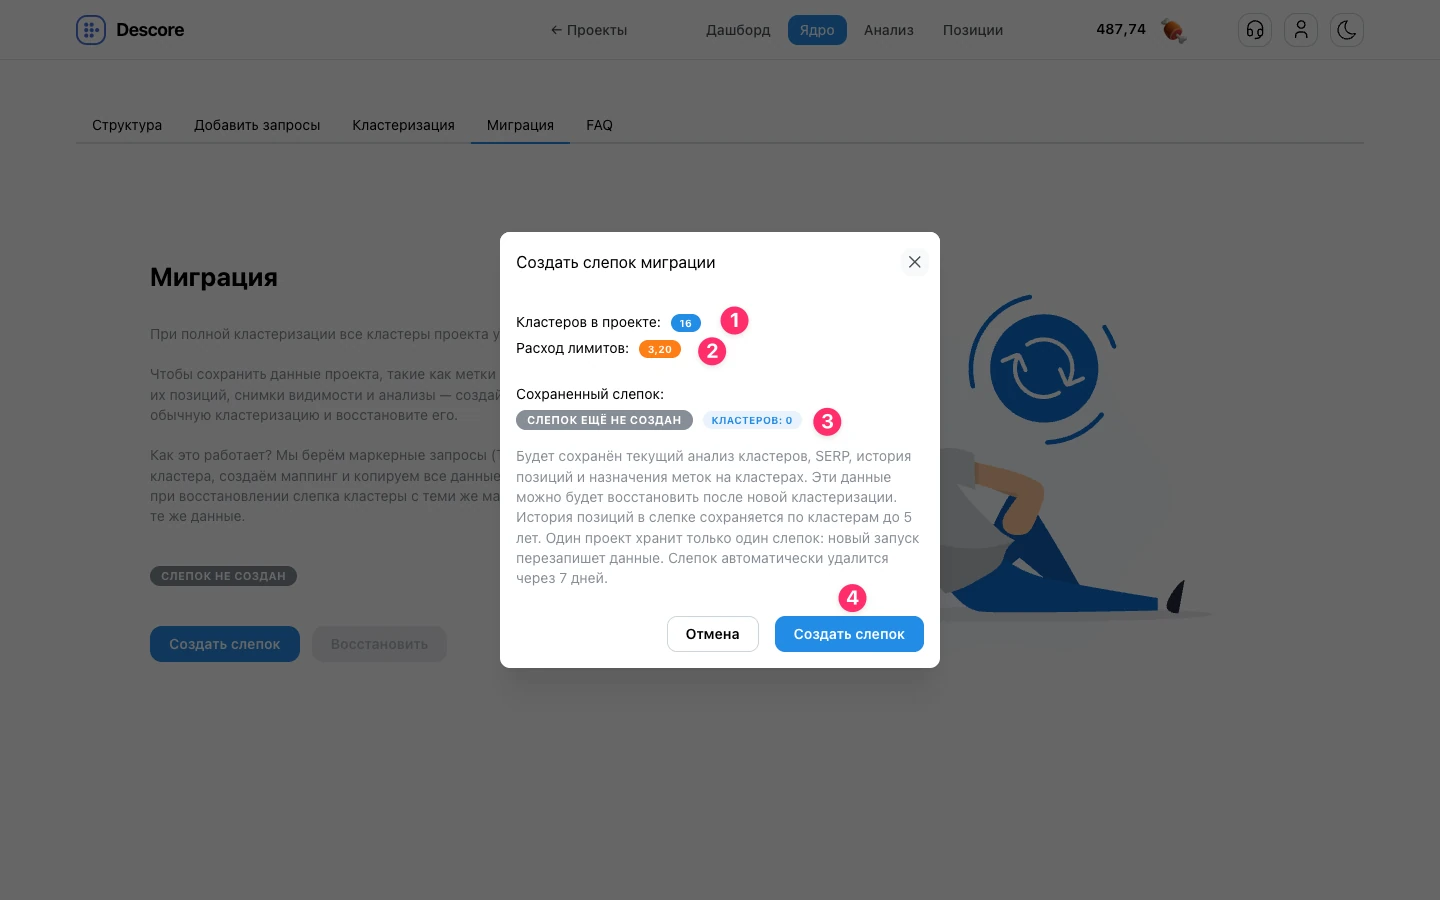
- 1 Кластеров в проекте — количество существующих кластеров текущей структуры (например, 16), данные которых будут сохранены в слепок.
- 2 Расход лимитов — списание лимитов по тарифу операции (0,20 лимита за 1 кластер: для 16 кластеров — 3,20 лимита).
- 3 Сохраненный слепок — текущий статус хранилища слепков проекта («Слепок ещё не создан» или дата предыдущего слепка).
- 4 Создать слепок — кнопка подтверждения и запуска фонового сохранения (рядом расположена кнопка «Отмена»).
В слепок архивируются данные уровня групп: текущий анализ кластеров, SERP-снимки видимости по кластерам, динамика суммарной частотности, историческая динамика видимости групп сайта до 5 лет (в дополнение к сохраняющейся базовой проверке позиций запросов) и назначения меток на кластерах и тегах. Слепок хранится в проекте 7 дней, после чего автоматически удаляется. В проекте хранится только один слепок: каждый новый запуск перезаписывает предыдущую копию.
Готовность слепка к восстановлению
После успешного создания слепка интерфейс обновляет индикаторы и открывает возможность восстановления структуры.
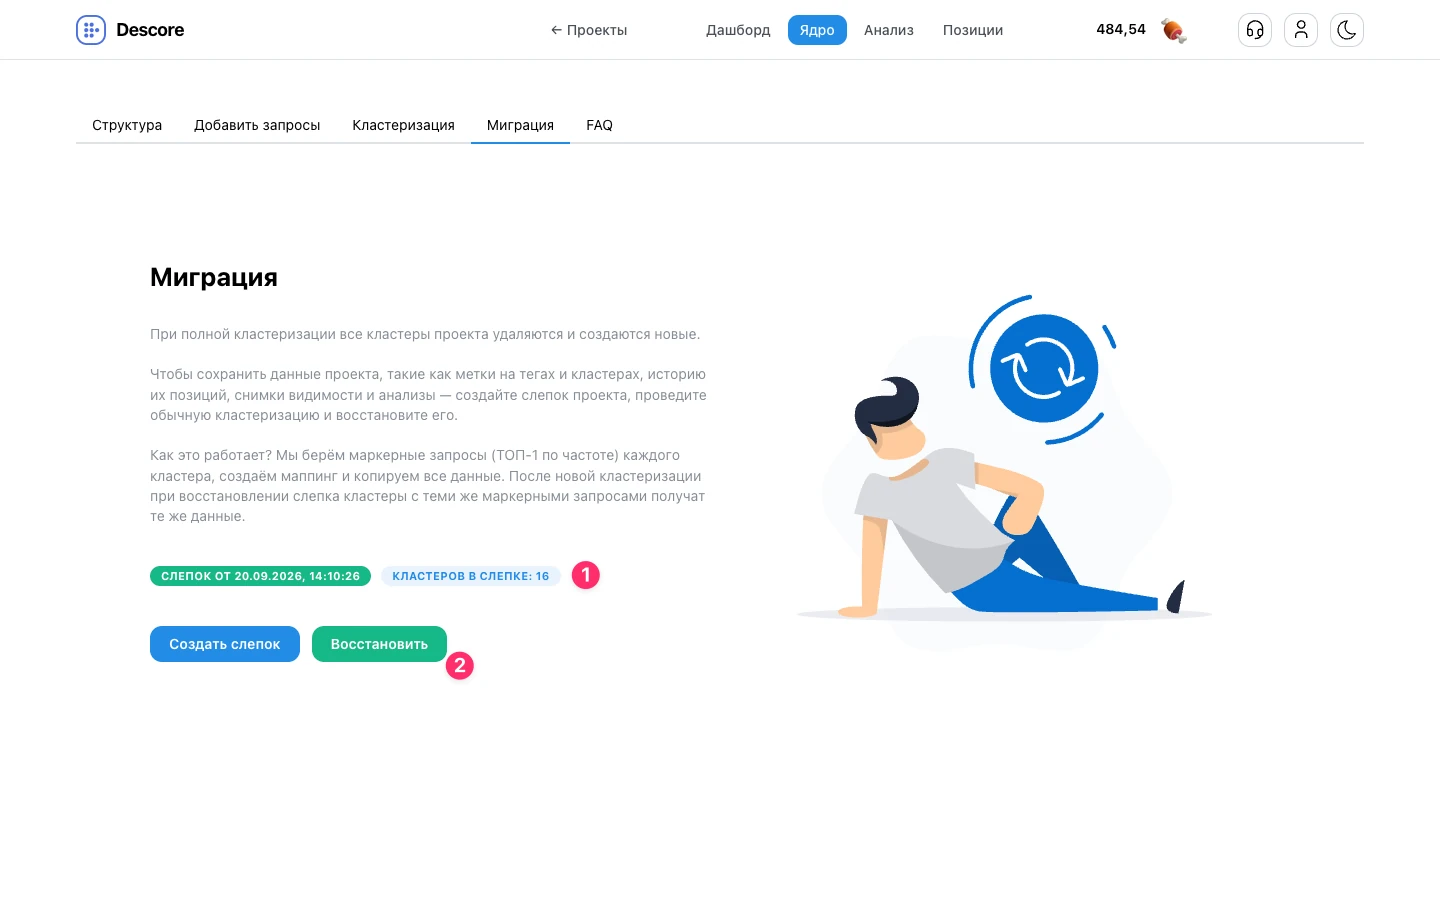
- 1 Индикаторы сохранённого слепка — зелёный бейдж с точной датой и временем создания («СЛЕПОК ОТ 20.09.2026, 14:10:26») и синий бейдж с числом кластеров в архиве («КЛАСТЕРОВ В СЛЕПКЕ: 16»).
- 2 Кнопка «Восстановить» — становится активной (зелёного цвета), позволяя запустить перенос данных из слепка на новую структуру после проведения кластеризации.
После сохранения слепка перейдите в раздел настройки и запуска кластеризации, задайте нужные параметры (силу группировки, глубину ТОПа) и выполните пересборку структуры ядра. После завершения кластеризации вернитесь во вкладку «Миграция» и нажмите «Восстановить».
Восстановление данных из слепка
При нажатии на кнопку «Восстановить» открывается модальное окно переноса артефактов из сохранённого слепка на новую структуру.
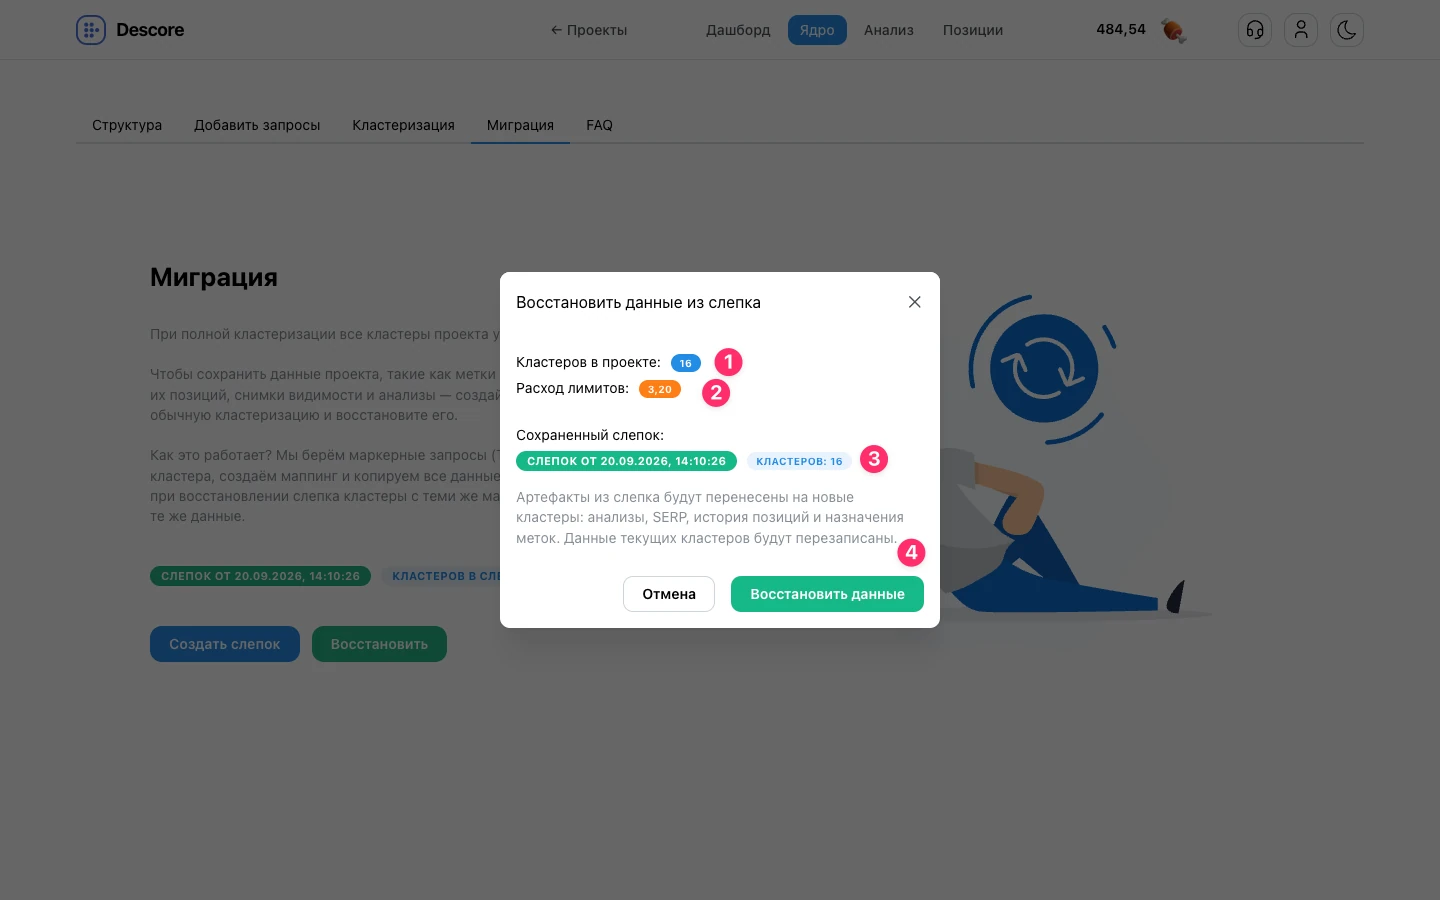
- 1 Кластеров в проекте — число кластеров в текущей структуре ядра.
- 2 Расход лимитов — предварительный расчёт резерва лимитов (0,20 лимита за каждый кластер в слепке: для 16 кластеров — 3,20 лимита). Фактическое списание происходит только за сопоставленные кластеры, неизрасходованный остаток возвращается.
- 3 Сохраненный слепок — дата фиксации и количество кластеров в используемом слепке.
- 4 Восстановить данные — кнопка запуска фонового процесса восстановления (рядом расположена кнопка «Отмена»).
Артефакты из слепка автоматически переносятся на новые кластеры: анализы, SERP-снимки, история позиций, динамика частотности и назначения меток. Данные новых кластеров при этом аккуратно перезаписываются сохранённой историей.
Вопросы и ответы
Зачем создавать слепок структуры перед полной кластеризацией проекта?
При запуске полной кластеризации всего проекта (режим «Весь проект») существующие группы удаляются и формируются заново. При этом история позиций по каждому отдельному поисковому запросу остаётся нетронутой — удаляется только история и аналитика на уровне кластеров (SERP-слепки видимости групп, динамика видимости кластеров, SEO-анализы и привязки меток). Создание слепка миграции позволяет зафиксировать эти кластерные данные и в один клик восстановить их в новой структуре.
Удаляется ли история позиций по запросам при перекластеризации без слепка?
Нет. История позиций по отдельным поисковым запросам (до 5 лет) хранится в базе данных независимо от структуры групп и никуда не удаляется. Без слепка миграции сбрасываются только производные данные уровня кластеров: исторические графики видимости групп, SERP-слепки видимости по кластерам, результаты SEO-анализа и пользовательские метки.
Как работает сопоставление кластеров по маркерным запросам?
В качестве якоря кластера система использует главный запрос (если он был задан пользователем вручную в настройках кластера), либо фразу с максимальной частотой Wordstat (при равенстве — с наименьшим системным ID). Поиск в новой структуре выполняется по постоянному идентификатору запроса: движок находит, в какой новый кластер попал исходный маркерный запрос, и переносит туда историю позиций, анализы, динамику частотности и метки. Если два старых кластера объединились в один новый, данные переносятся для первого сопоставленного кластера для защиты от перезаписи.
Сколько времени хранится слепок миграции и сколько слепков можно создать?
Слепок миграции хранится в проекте 7 дней, после чего автоматически удаляется фоновым процессом обслуживания. В одном проекте хранится ровно один слепок: повторный запуск создания слепка перезаписывает предыдущие сохранённые данные.
Сколько стоит создание слепка и восстановление данных?
Каждая операция тарифицируется по ставке 0,20 лимита за 1 кластер проекта. При создании слепка из 16 кластеров списывается 3,20 лимита. При восстановлении сначала резервируется сумма по размеру слепка, однако итоговое списание происходит только за фактически сопоставленные и восстановленные кластеры. Неиспользованный остаток автоматически возвращается из резерва на баланс проекта.
Нужно ли создавать слепок, если кластеризуются только «Несортированные»?
Нет. В режиме «Только «Несортированные»» существующая структура кластеров и тегов не удаляется и не пересобирается — система обрабатывает только новые запросы из рабочей папки. Слепок миграции необходим именно перед полной кластеризацией в режиме «Весь проект».
Что произойдёт с кластерами, у которых после перекластеризации изменился состав?
Если структура перестроилась, но маркерный запрос старого кластера попал в одну из новых групп, система безошибочно привяжет к ней сохранённую историю. Если же старая группа распалась полностью и маркерный запрос был удалён из ядра, данные этого кластера останутся в архиве слепка без сопоставления, а лимиты за его восстановление не спишутся.
Связанные разделы руководства
- Структура: теги — иерархический верхний уровень таблицы семантики: колонки показателей, средневзвешенная позиция, переименование, объединение тегов и изменение меток.
- Кластеризация — создание SERP-слепков, настройка объёма мониторинга («Экономия» vs «Все запросы»), сила группировки и поиск каннибализации.
- Таблица буфера — массовые операции, углубление сбора Wordstat, обновление частот и перенос фраз в проект.
- Метки — система сквозных меток проекта, фиксация времени назначения и контроль этапов оптимизации.
- Тарифы и модель оплаты — ставки платных операций и правила списания лимитов.