

Как быстро почистить шумную семантику
После проведения автоматической кластеризации в семантическом ядре нередко оказываются околоцелевые, нерелевантные или мусорные фразы, попавшие из широкого парсинга Wordstat или импорта сторонних файлов. Метрика «Шумность» позволяет за пару минут выявить аномальные ветки, отфильтровать их по числовому порогу и удалить в один клик.
Что такое шумность и как она рассчитывается
Шумность (от 0 до 100%) — показатель степени отличия поисковой выдачи (SERP) по запросам конкретного тега от общего тематического профиля всего семантического ядра проекта.
Принцип работы: если в исходном наборе поисковых фраз присутствовали информационные статьи, ремонтные услуги, отзывы или смежные запросы среди коммерческого каталога, алгоритм собирает их в отдельные кластеры и теги. Поскольку сайты-конкуренты в выдаче по таким фразам кардинально отличаются от профиля основного ядра сайта, система присваивает этим тегам высокий процент шумности.
Когда рассчитывается шумность:
- При кластеризации проекта (автоматически): алгоритм сопоставляет распределение сайтов в выдаче для каждого тега со сводным профилем ядра (используя дивергенцию Йенсена-Шеннона).
- При объединении тегов: показатель шумности мгновенно пересчитывается взвешенно с учётом суммарной частотности объединяемых групп.
Шаг 1. Сортировка по шумности и определение границы
Перейдите в модуль «Ядро» на вкладку «Структура». В таблице тегов нажмите на заголовок колонки «Шумность», чтобы отсортировать список от большего к меньшему (по убыванию).
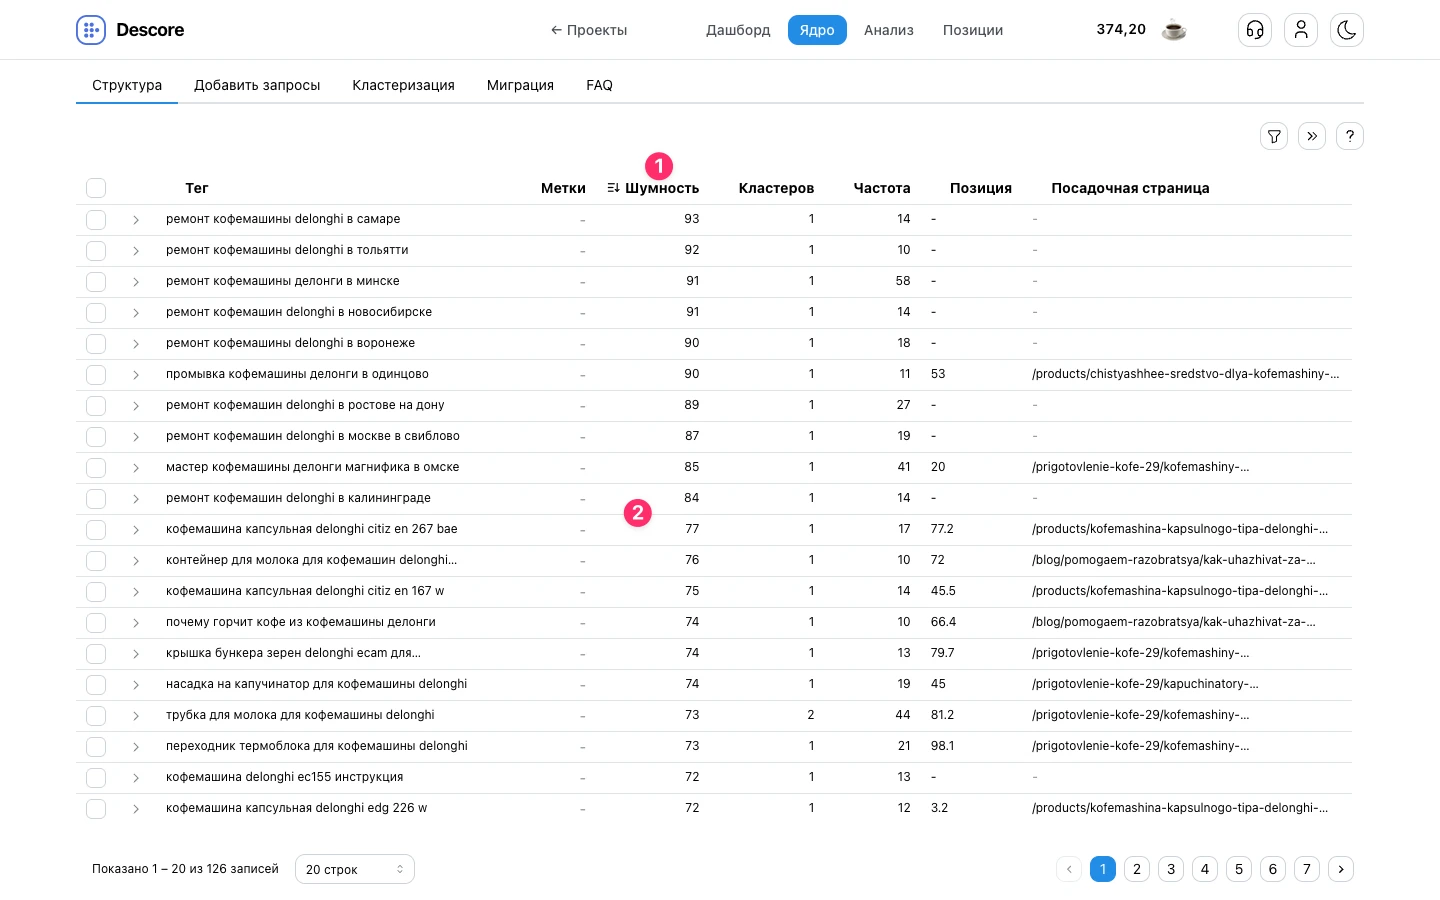
- 1 Сортировка по колонке «Шумность» — первый клик по заголовку упорядочивает теги от самых шумных (93%, 92%, 91%...) к целевым.
- 2 Определение границы шумной семантики — прокручивая отсортированную таблицу вниз, найдите границу, где заканчивается мусорная семантика. В рассматриваемом примере проекта по продаже кофемашин и запчастей:
- Выше границы (84–93%): собраны сервисные гео-запросы на ремонт кофемашин в других городах («ремонт кофемашины delonghi в самаре», «в тольятти», «в минске», «в новосибирске», «в одинцово»). По ним у магазина нет посадочных страниц (прочерки в колонке) и нет позиций в выдаче.
- Ниже границы (77% и меньше): начинается целевая семантика каталога и блога («кофемашина капсульная delonghi citiz», «контейнер для молока», «крышка бункера зерен») с реальными посадочными страницами разделов сайта (
/products/...и/blog/...).
Шаг 2. Проверка состава через раскрытие тегов и кластеров
Если вы сомневаетесь в оценке отдельного тега или хотите убедиться, какие именно ключевые фразы в него входят, раскройте вложенную иерархию прямо в строке таблицы.
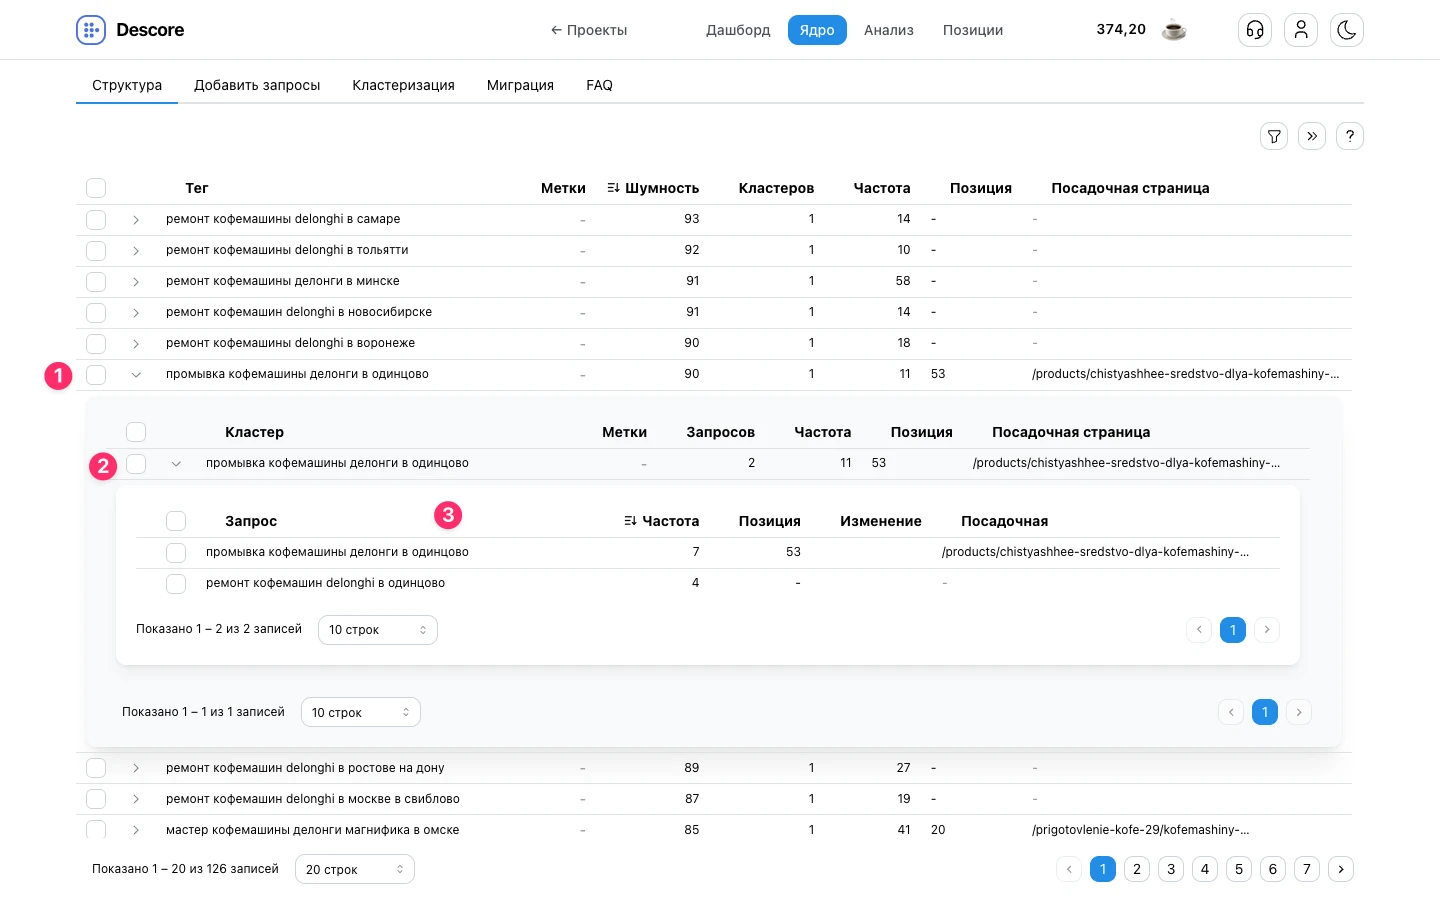
- 1 Раскрытие строки тега — клик по стрелке слева от чекбокса показывает вложенные кластеры, входящие в этот тег.
- 2 Просмотр входящих кластеров — отображаются название кластера, число входящих в него запросов, суммарная частота и назначенная посадочная страница. Клик по стрелке кластера открывает список запросов.
- 3 Анализ поисковых запросов — таблица конкретных ключевых фраз. На примере тега «промывка кофемашины делонги в одинцово» (шумность 90%) видно, что внутри находятся фразы сервисного ремонта («промывка кофемашины delonghi в одинцово» с частотой 7 и «ремонт кофемашин delonghi в одинцово» с частотой 4), которые подтверждают нерелевантность ветки.
Шаг 3. Фильтрация таблицы по условию «Шумность > N»
После того как вы определили границу шумности (в нашем примере — 80), отфильтруйте таблицу, чтобы оставить только мусорные теги.
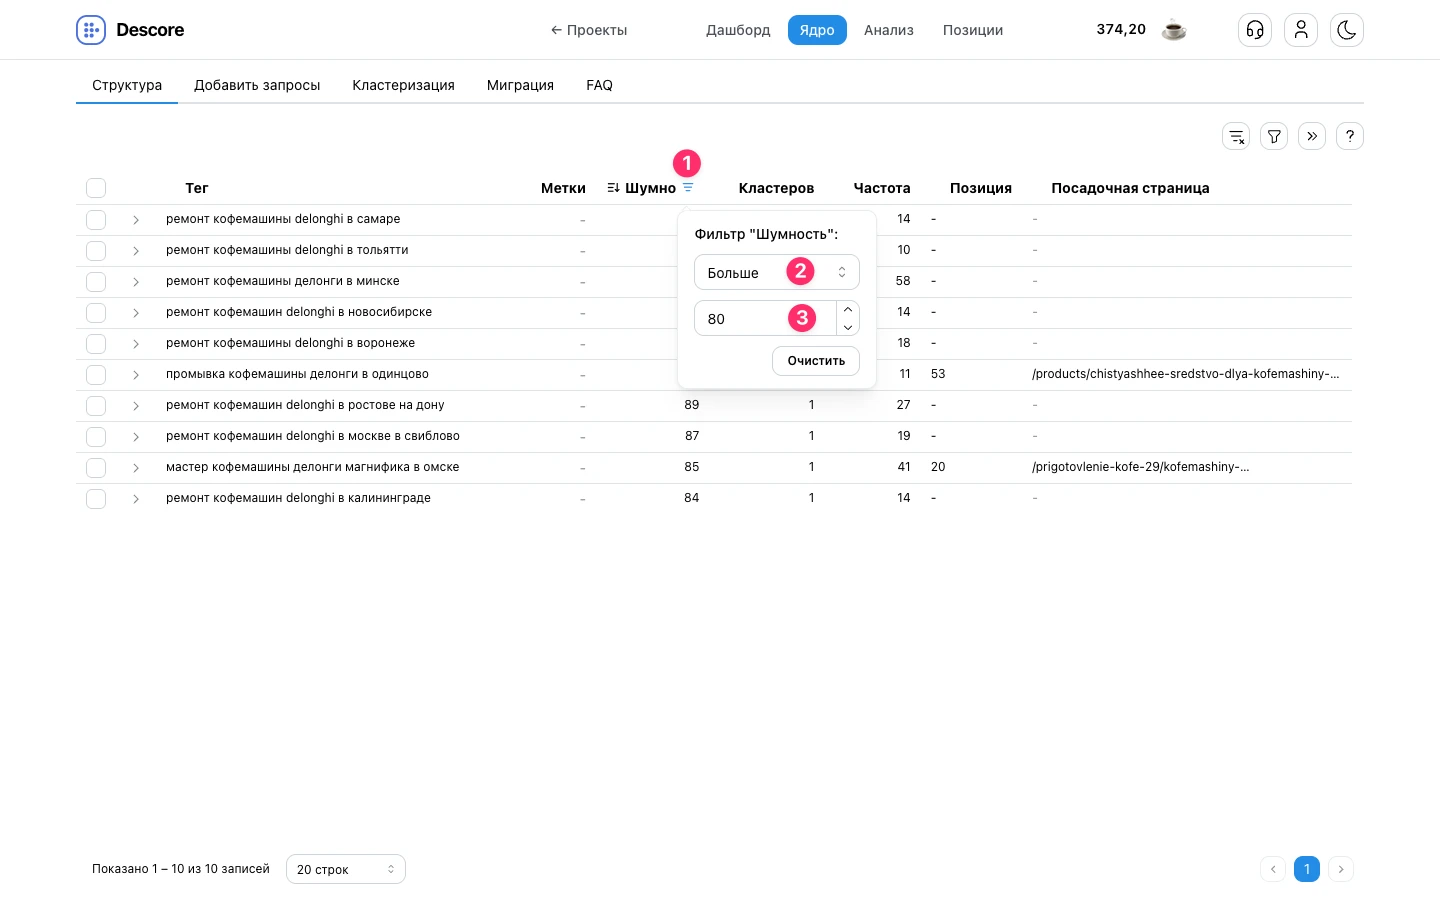
- 1 Вызов фильтра колонки — наведите курсор на заголовок колонки «Шумность» и нажмите на появившуюся иконку фильтра.
- 2 Выбор условия — в выпадающем списке выберите «Больше».
- 3 Ввод порога — укажите числовое значение (в нашем примере —
80). Таблица отфильтруется и покажет только теги со значением выше заданного порога.
Шаг 4. Массовый выбор отфильтрованных тегов
Когда в таблице останутся только отфильтрованные шумные теги, выделите их через чекбокс в шапке.
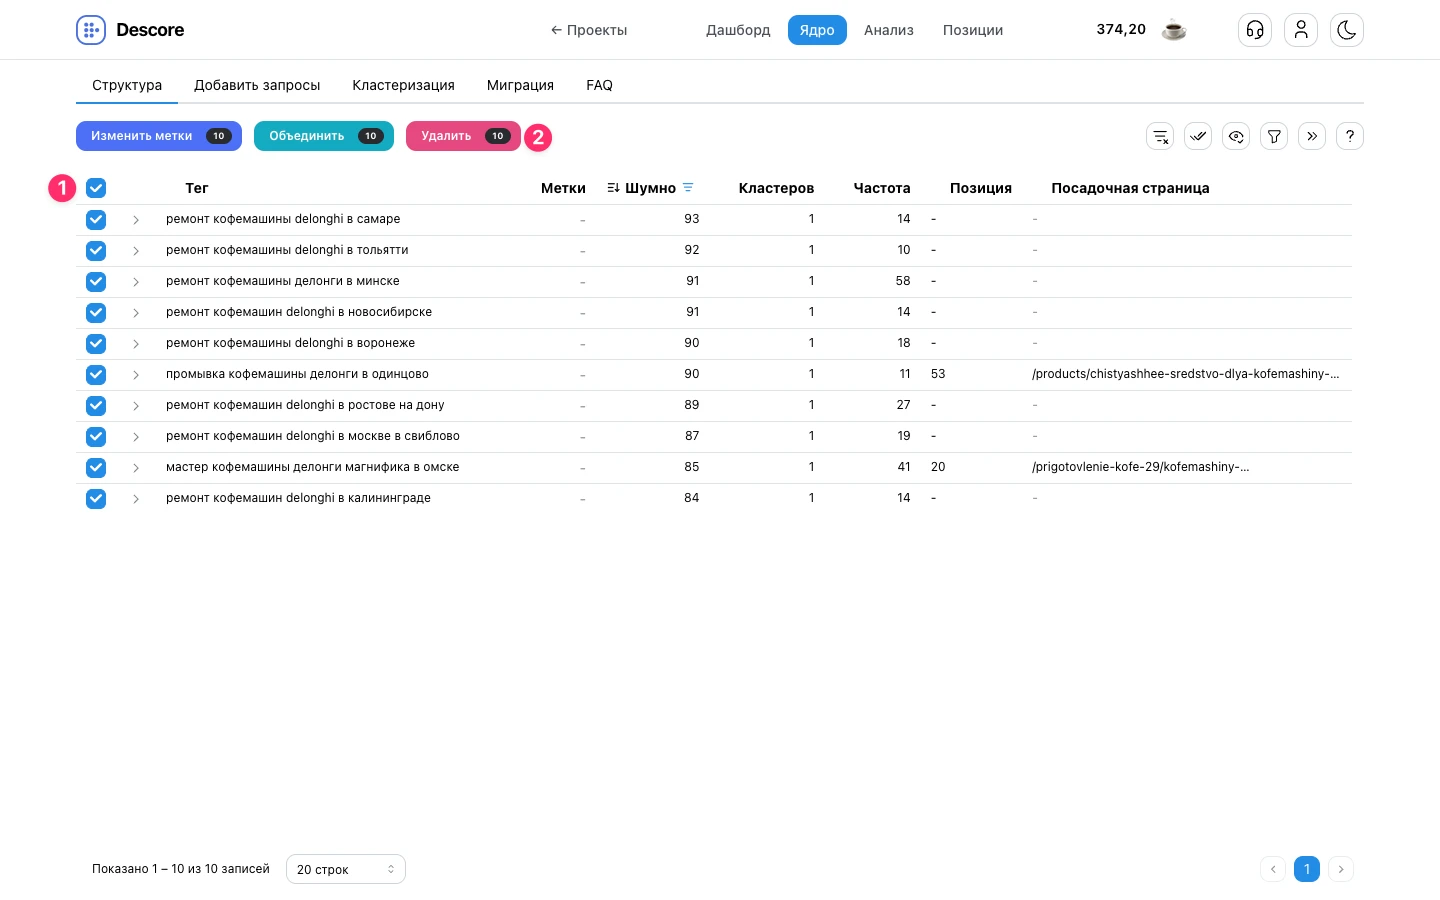
- 1 Чекбокс в шапке таблицы — клик по верхнему чекбоксу рядом с колонкой «Тег» выделяет сразу все отфильтрованные строки.
- 2 Кнопка удаления — появляется над таблицей на панели групповых действий со счётчиком выбранных строк (в примере — «Удалить 10»).
Шаг 5. Удаление нерелевантных тегов
Нажмите красную кнопку удаления на панели действий. Откроется окно подтверждения операции.
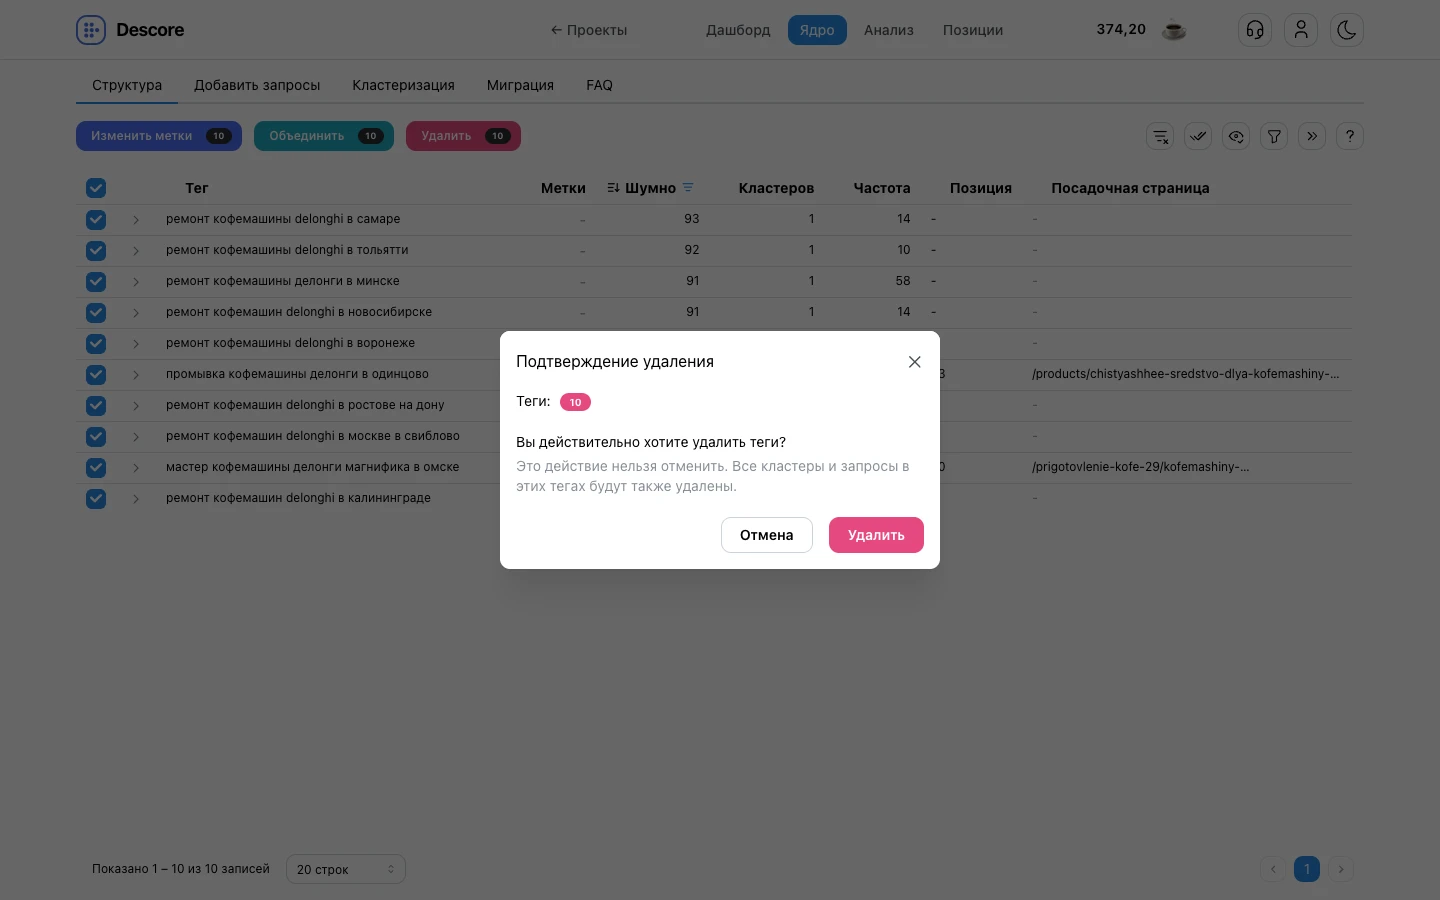
- Количество тегов — в модальном окне отображается точное число тегов, выбранных для удаления.
- Каскадное удаление — действие необратимо: вместе с тегами будут полностью удалены все входящие в них кластеры и запросы.
- Подтверждение очистки — нажмите кнопку «Удалить». Таблица очистится от мусорной семантики, а проектный лимит освободится для новых запросов.
Часто задаваемые вопросы
Что такое «Шумность» и почему у некоторых тегов высокий процент?
Показатель шумности (от 0 до 100%) рассчитывается во время кластеризации: алгоритм сопоставляет сайты в поисковой выдаче по фразам тега со сводным доменным профилем ядра. Если выдача по группе кардинально отличается от тематики проекта (например, сервисные услуги или форумы вместо каталога интернет-магазина), тег получает высокую оценку шумности.
Какое значение шумности считать порогом для удаления?
Фиксированного универсального числа нет — порог зависит от тематики и состава ядра. Как правило, явный мусор и нецелевые ветки группируются выше 75–80%. Рекомендуется отсортировать таблицу по убыванию и визуально найти границу, где заканчиваются мусорные фразы и начинается целевая семантика.
Что делать, если внутри шумного тега есть нужный кластер?
Перед фильтрацией и массовым удалением раскройте тег и перенесите нужный кластер в другой, подходящий тег, либо просто снимите отметку с этого тега перед нажатием кнопки «Удалить».
Можно ли восстановить удалённые теги, кластеры и запросы?
Нет, удаление является необратимым. При подтверждении удаления из проекта полностью стираются выбранные теги, а также все входящие в них кластеры и ключевые фразы.
Связанные руководства
- Структура: теги — полный обзор интерфейса верхнего уровня структуры, показателей таблицы и одиночных/групповых операций.
- Кластеризация — настройка параметров группировки запросов, сила связи и генерация структуры.
- Таблица буфера — первичная очистка и фильтрация запросов в staging-буфере до переноса в проект.