

Вкладка «Кластеризация»
Вкладка «Кластеризация» отвечает за автоматическую группировку семантики на основе поисковой выдачи основной цели (Яндекс). Алгоритм кластеризации семантического ядра объединяет фразы в кластеры без ограничений Hard / Soft, распределяет запросы по целевым посадочным страницам, выявляет каннибализацию и формирует настройки для мониторинга позиций сайта.
Шаг 2: Создайте SERP-слепок
Перед запуском кластеризации система собирает поисковую выдачу по запросам проекта и фиксирует текущие позиции сайта.
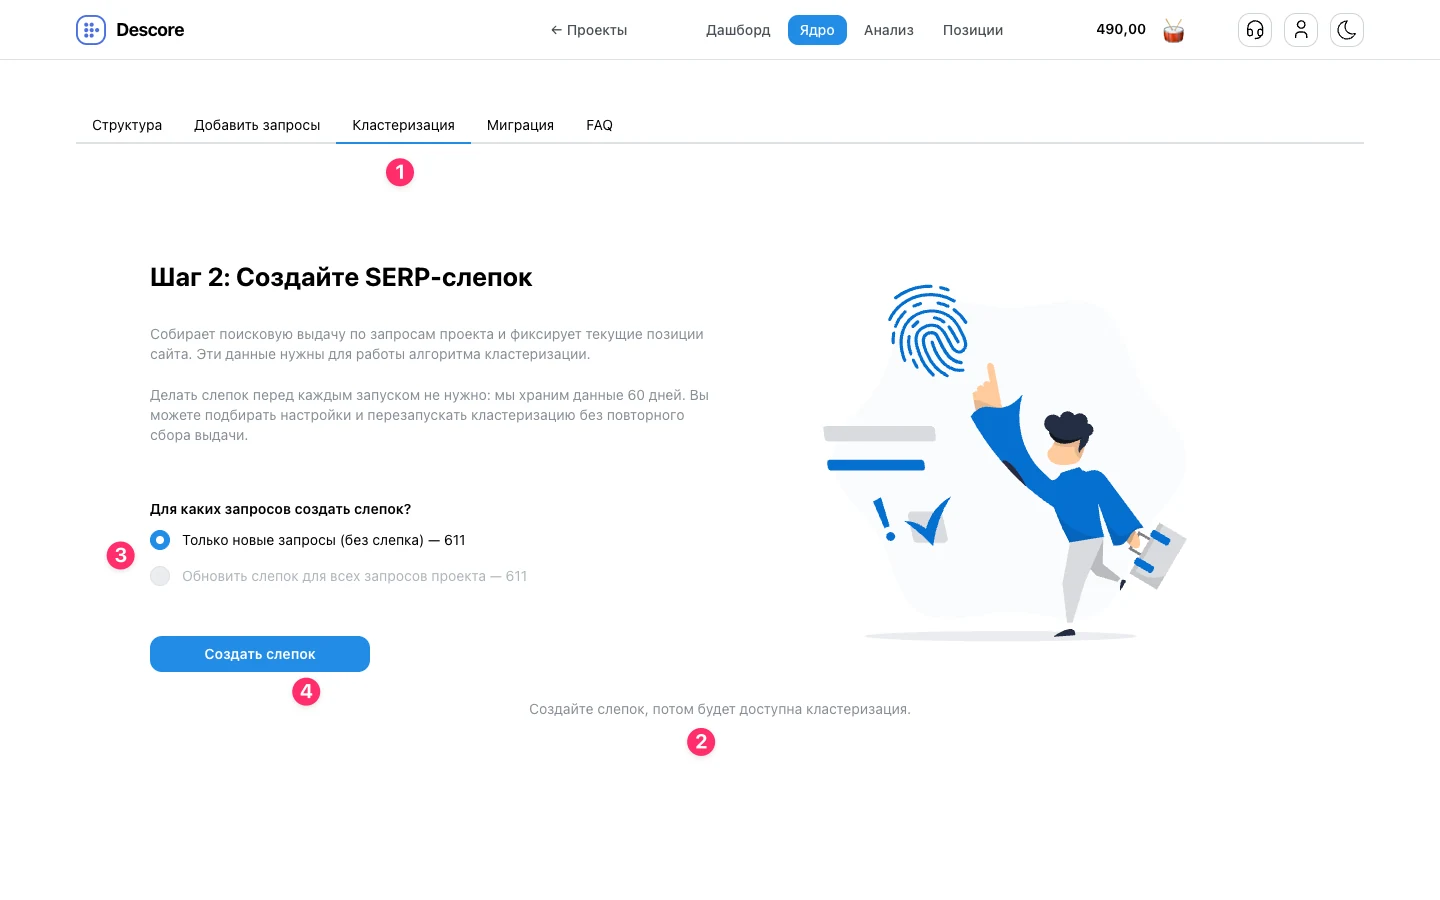
- 1 Вкладка «Кластеризация» — расположена в меню модуля «Ядро».
- 2 Подсказка — статус «Создайте слепок, потом будет доступна кластеризация.» указывает, что кластеризация станет доступна после сбора данных выдачи.
- 3 Для каких запросов создать слепок? — выбор охвата:
- Только новые запросы (без слепка) — собирает выдачу только по добавленным фразам без повторной оплаты за уже собранные ключи.
- Обновить слепок для всех запросов проекта — повторный сбор выдачи по всей семантике проекта.
- 4 Создать слепок (или «Обновить слепок») — открывает окно с расчётом лимитов и подтверждением.
Собранные срезы SERP хранятся в проекте 60 дней. В течение этого срока вы можете изменять параметры алгоритма и перезапускать кластеризацию на базе сохранённых данных выдачи без повторной оплаты за сбор слепка (при каждом запуске кластеризации списывается только тариф за саму кластеризацию — 0,10 лимита за запрос).
Модальное окно подтверждения слепка SERP
При нажатии на кнопку создания слепка открывается модальное окно с параметрами запуска и расчётом лимитов.
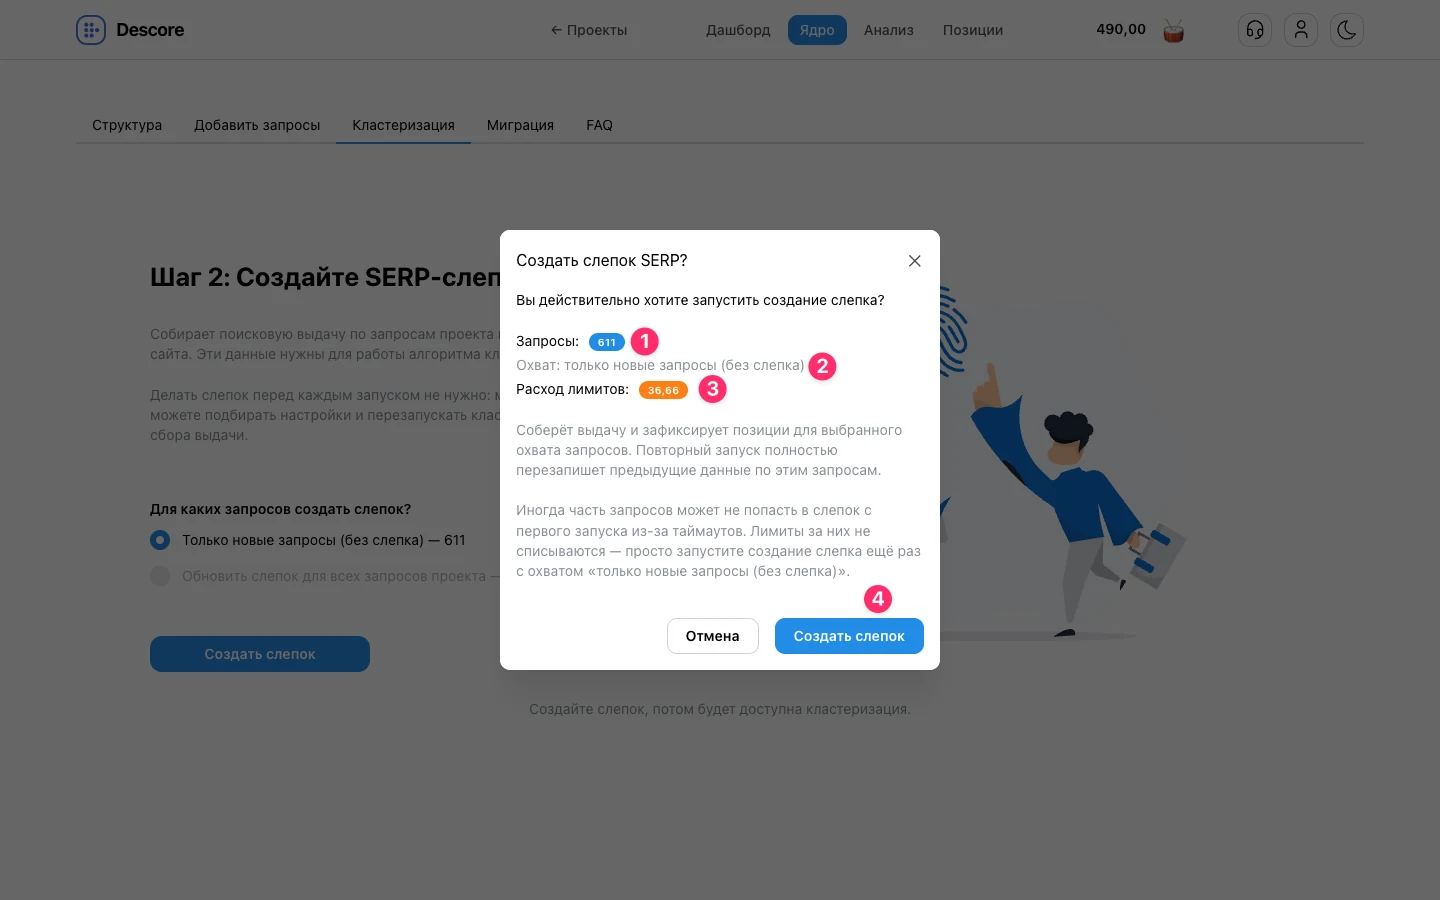
- 1 Запросы — количество запросов, для которых будет собран слепок.
- 2 Охват — выбранный режим сбора («Только новые запросы» или «Все запросы проекта»).
- 3 Расход лимитов — списание лимитов по тарифу операции (0,06 лимита за запрос: сбор выдачи ТОП-20 и фиксация позиций).
- 4 Создать слепок — кнопка запуска сбора (рядом кнопка «Отмена»).
Если часть запросов не собралась из-за задержек поисковой системы, лимиты за них не списываются. Можно повторно запустить сбор с охватом «Только новые запросы (без слепка)».
Шаг 3: Настройте объём мониторинга
В проекте можно хранить полную семантику с широким хвостом запросов для структуры и посадочных страниц. Шаг 3 позволяет настроить объём отслеживания позиций и оптимизировать расход лимитов на регулярный мониторинг.
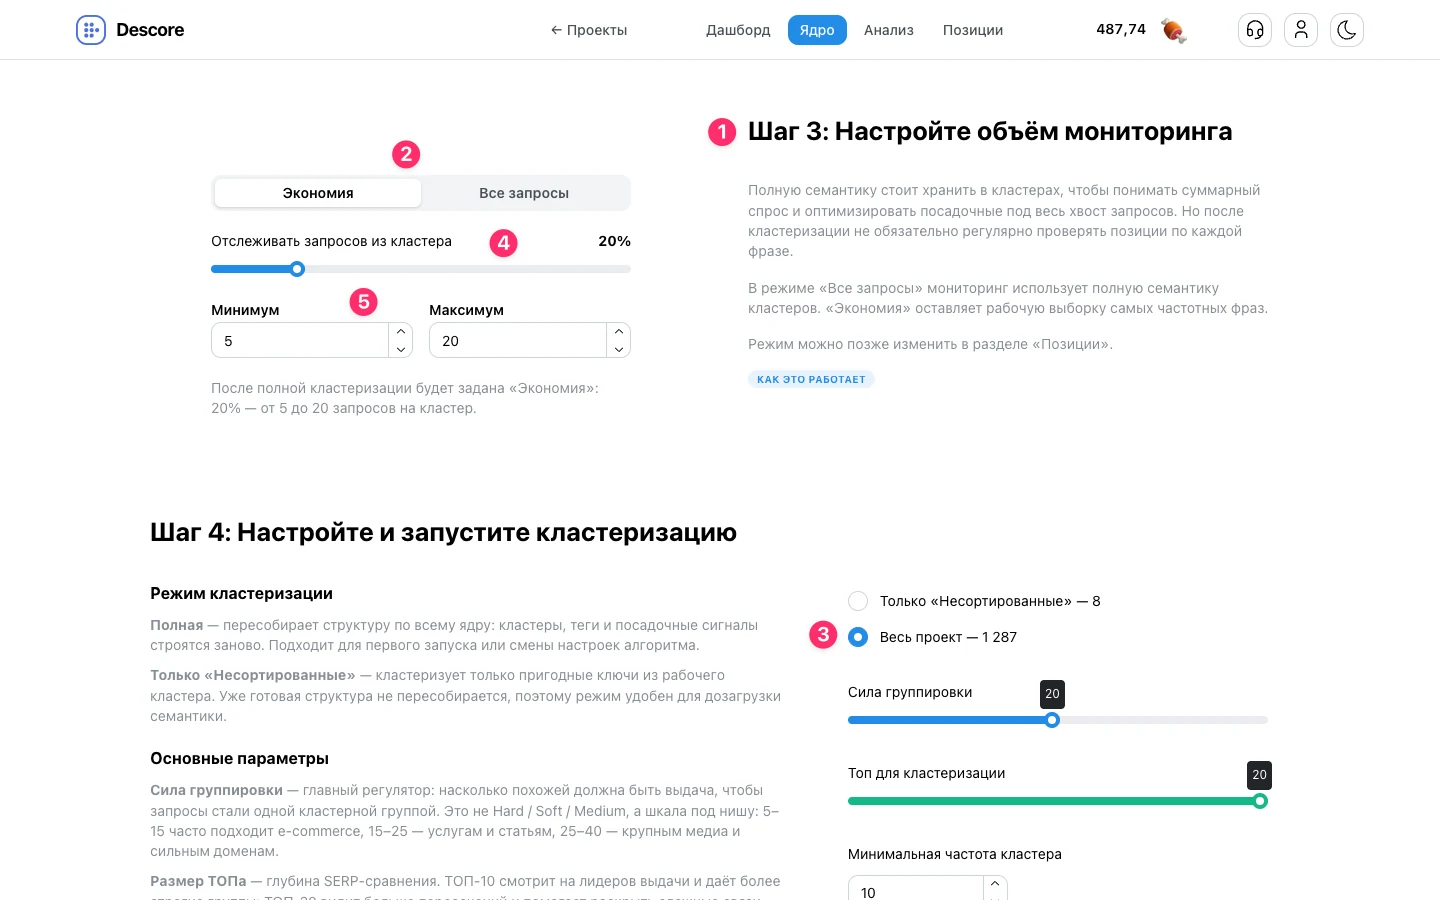
- 1 Заголовок — «Шаг 3: Настройте объём мониторинга» (для небольших проектов до 1 000 фраз отображается как рекомендация).
- 2 Режим мониторинга:
- Экономия — отбирает процент самых частотных запросов из каждого кластера для регулярного съёма позиций.
- Все запросы — отслеживает позиции по всем фразам кластеров проекта.
- 3 Переключение режимов — переключатель режимов мониторинга («Экономия» / «Все запросы») доступен только тогда, когда в Шаге 4 выбран режим «Весь проект». В режиме «Только «Несортированные»» структура проекта не пересобирается, поэтому переключение заблокировано.
- 4 Отслеживать запросов из кластера — процент фраз (от 1% до 100%, по умолчанию 20%), который отбирается из каждого кластера.
- 5 Минимум и Максимум — коридор выборки на кластер:
- Крупный кластер: при 120 запросах 20% — это 24 фразы. При максимуме 20 в мониторинг попадут 20 самых частотных запросов.
- Малый кластер: при 15 запросах 20% — это 3 фразы. При минимуме 5 в мониторинг войдут 5 самых частотных запросов.
Режим отслеживания позиций и состав ключевых фраз можно изменить позже во вкладке «Позиции».
Шаг 4: Настройте и запустите кластеризацию
Алгоритм Descore группирует поисковые запросы по совпадению URL в ТОПе выдачи. На этом шаге задаются сила связей, глубина анализа и правила обработки малых групп.
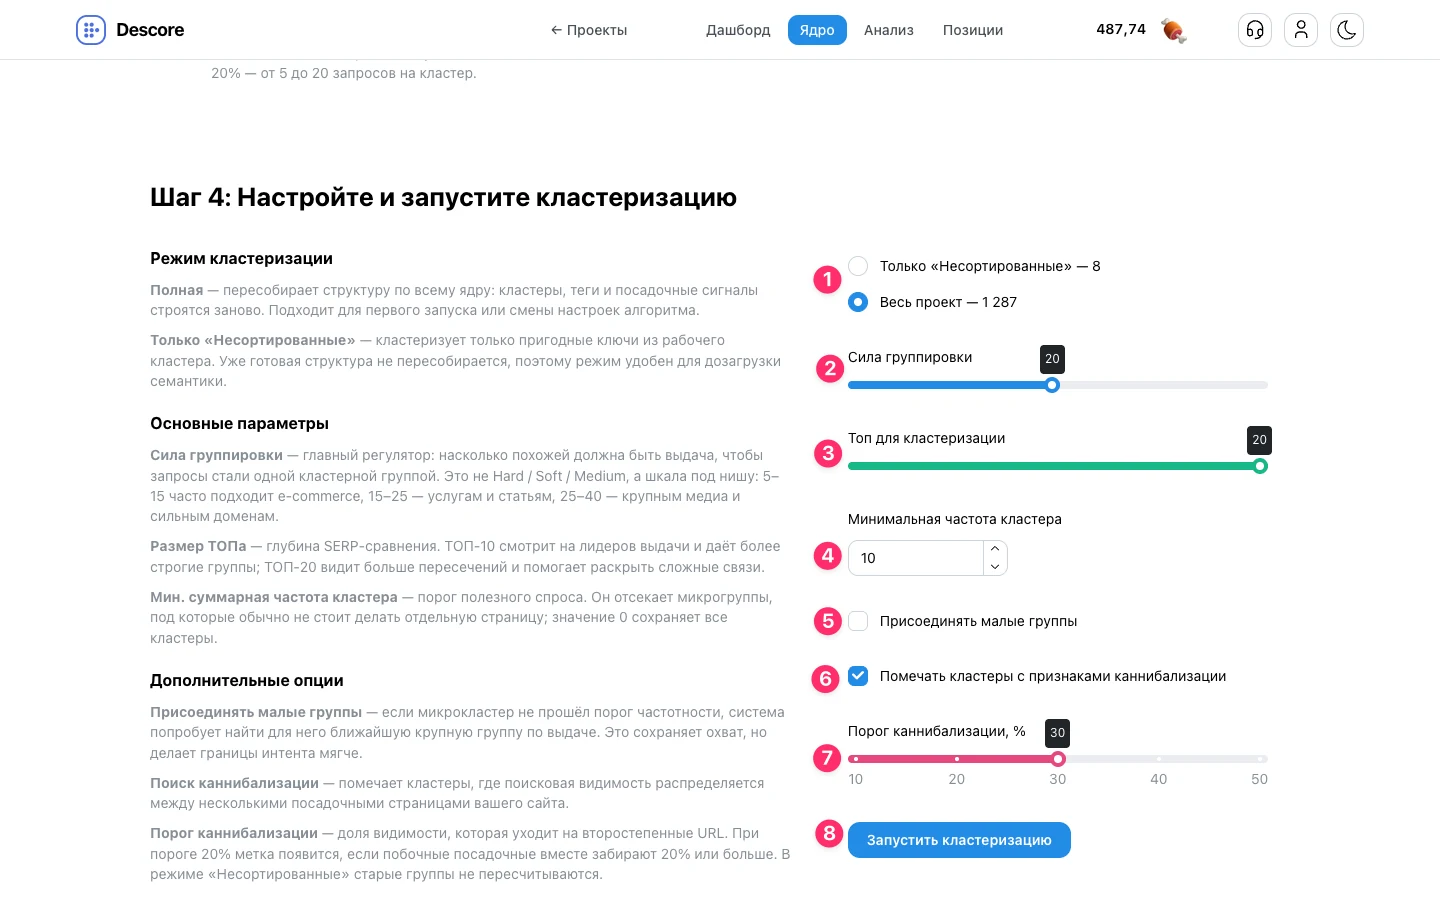
- 1 Режим кластеризации:
- Только «Несортированные» — кластеризует запросы из системного кластера «Несортированные», не меняя остальную структуру проекта.
- Весь проект — пересобирает всю структуру ядра заново.
- 2 Сила группировки (1–40, по умолчанию 20) — степень сходства выдачи для объединения запросов в один кластер:
- 5–15: подходит для интернет-магазинов и каталогов товаров.
- 15–25: для сайтов услуг и информационных статей.
- 25–40: для крупных медиа, порталов и узких интентов.
- 3 Топ для кластеризации (5–20, по умолчанию 20) — глубина анализа выдачи:
- ТОП-10: анализирует первую десятку результатов, формируя более строгие группы.
- ТОП-20: охватывает выдачу до 20 позиции, выявляя связи для длинных запросов.
- 4 Минимальная частота кластера (по умолчанию 10) — отсекает микрогруппы с низким спросом. Значение 0 сохраняет все кластеры.
- 5 Присоединять малые группы — если кластер не набрал минимальную частоту, система присоединяет его к ближайшей по выдаче крупной группе.
- 6 Помечать кластеры с признаками каннибализации — включает поиск конкуренции между страницами сайта в выдаче.
- 7 Порог каннибализации (10–50%, по умолчанию 30%) — доля видимости на второстепенных URL, при которой кластер помечается меткой каннибализации.
- 8 Запустить кластеризацию — открывает окно подтверждения.
Модальное окно подтверждения кластеризации
Перед запуском сервис показывает сводку выбранных параметров и требует подтверждения при полной пересборке структуры.
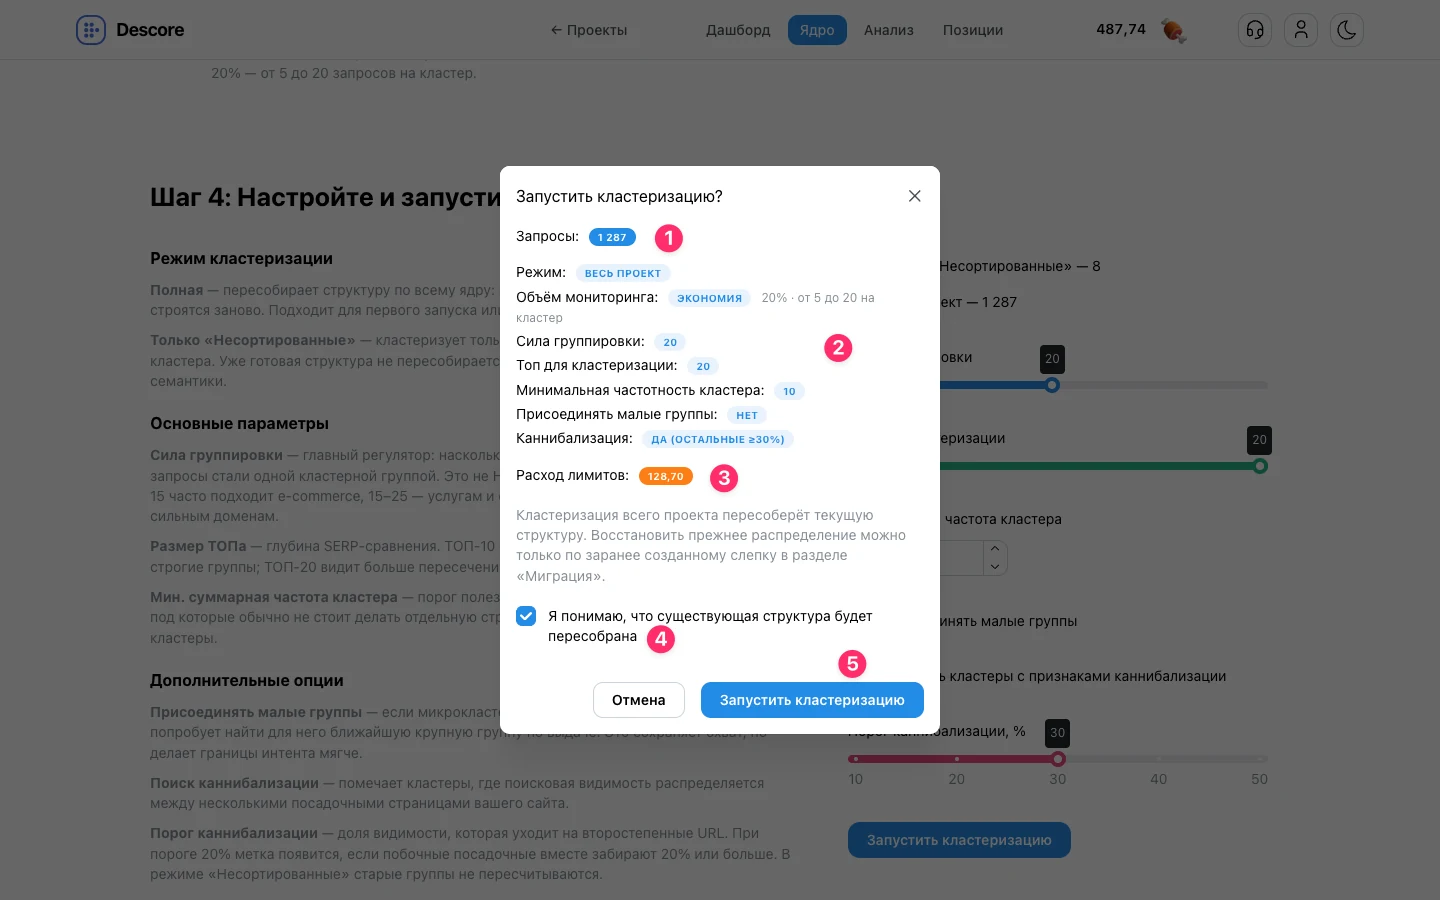
- 1 Запросы — общее число запросов, участвующих в кластеризации.
- 2 Параметры — сводка выбранных настроек: режим, объём мониторинга, сила группировки, глубина ТОПа, минимальная частота, присоединение малых групп и каннибализация.
- 3 Расход лимитов — списание лимитов по тарифу кластеризации (0,10 лимита за запрос).
- 4 Подтверждение пересборки — обязательный чекбокс «Я понимаю, что существующая структура будет пересобрана» при выборе режима «Весь проект».
- 5 Запустить кластеризацию — кнопка запуска задачи (рядом кнопка «Отмена»).
Вопросы и ответы
В чём разница между созданием SERP-слепка и запуском кластеризации?
SERP-слепок — это сбор поисковой выдачи (ТОП-10 или ТОП-20) по фразам проекта в выбранном регионе и фиксация текущих позиций сайта. Кластеризация — это группировка запросов по смыслу и общим URL в выдаче. Сначала создаётся слепок, затем запускается кластеризация.
Почему настройка объёма мониторинга (Шаг 3) недоступна в режиме «Только Несортированные»?
В режиме «Только «Несортированные»» система кластеризует только новые запросы из рабочего кластера и не меняет остальную структуру проекта. Правило Key Queries задаётся на уровне всего проекта. Чтобы переключить режим «Экономия / Все запросы» или изменить коридор min/max, выберите режим «Весь проект».
Сколько времени хранятся SERP-слепки и как тарифицируется повторный запуск кластеризации?
Собранные SERP-слепки хранятся 60 дней. В течение этого срока повторно оплачивать сбор выдачи (0,06 лимита за запрос) не нужно — вы можете изменять параметры алгоритма (силу группировки, глубину ТОПа, минимальную частоту) и запускать пересборку на основе сохранённых данных. При этом каждый запуск кластеризации тарифицируется отдельно — списывается 0,10 лимита за запрос за проведение алгоритмических расчётов и формирование структуры.
Как восстановить прежнюю структуру, если результат полной пересборки не подошёл?
Перед запуском полной кластеризации проекта можно сохранить слепок структуры во вкладке «Миграция». При необходимости проект восстанавливается из сохранённого слепка в один клик.
Какую силу группировки выбрать для интернет-магазина, а какую для сайта услуг?
Для интернет-магазинов и каталогов товаров обычно выбирают диапазон 5–15 (более широкие группы под товарные страницы); для сферы услуг, B2B и статей — 15–25; для крупных медиа и порталов с узкими интентами — 25–40.
Что означает метка каннибализации и как рассчитывается её порог?
Каннибализация означает, что по запросам кластера поисковая видимость распределяется между несколькими URL вашего сайта. Порог каннибализации (10–50%) задаёт долю видимости на второстепенных страницах. При пороге 30% метка присвоится, если побочные URL забирают 30% и более общей видимости.
Что происходит с микрокластерами, если включена опция «Присоединять малые группы»?
Если кластер не набрал минимальную суммарную частоту, при включённой опции система находит для него ближайшую крупную группу по выдаче и присоединяет к ней.
Связанные разделы руководства
- Таблица буфера — массовые операции, углубление сбора Wordstat, обновление частот и перенос фраз в проект.
- Добавление запросов — импорт семантики из CSV/XLSX с сопоставлением колонок и первичный сбор через Wordstat API.
- Поисковые цели — регионы, мобильная и десктопная выдача для Яндекса и Google.
- Тарифы и модель оплаты — стоимость операций создания слепков SERP и кластеризации семантики.