

Слова запросов кластера: словарь, частотные корзины и упущенные слова
Раздел «Слова запросов кластера» детального отчёта разбирает поисковые фразы кластера на лексические основы и распределяет их по доле от суммарной частотности Wordstat — по корзинам от 50% до 0.1%.
Инструмент сопоставляет словарь поискового спроса с посадочной страницей и показывает, какие слова запросов отсутствуют в контенте. Эти слова также учитываются при расчёте кластерного BM25.
Где находится блок слов запросов
В основном меню откройте «Анализ» → вкладка «SERP» и кликните по названию кластера. В детальном отчёте прокрутите экран ниже Z-метрик, документов топа, графиков Ципфа, N-грамм, Метатегов и блока «Покрытие» до раздела «Слова запросов кластера».
Блок показывает данные сохранённого анализа. После правок страницы нажмите «Обновить анализ», чтобы проверить обновлённый текст.
Зачем нужен анализ слов запросов кластера
Блок «Покрытие» показывает лексику документов топа. «Слова запросов кластера» помогают сверить страницу с формулировками поисковых запросов, которые могут отличаться от текста конкурентов.
Кластер объединяет десятки или сотни ключевых фраз: от высокочастотных маркерных запросов до длиннохвостого спроса (Long Tail). Частотность фраз распределяется неравномерно: одни слова входят в запросы с большой долей суммарной частотности кластера, другие встречаются в редких формулировках. Проценты корзин описывают частотность запросов, а не долю фактического трафика страницы.
Блок «Слова запросов кластера» решает принципиальные задачи оптимизации:
- Выделяет наиболее частотные слова запросов: показывает слова с большой накопленной частотой Wordstat (верхние корзины 50% и 20%). Начните с них проверку пропусков и определите, какие слова относятся к теме страницы.
- Выявляет скрытый лексический дефицит (gap-анализ спроса): сопоставляет словарь запросов с посадочной страницей. Список помогает найти слова, которые встречаются в поисковых запросах и отсутствуют в контенте страницы.
- Помогает выбрать порядок проверки: частотные группы позволяют начать с наиболее частотных слов запросов, затем перейти к остальным. Отбирайте подходящие леммы с учётом темы и задачи страницы.
Структура блока и итоговая сводка спроса
В исходном состоянии оба аккордеона свёрнуты. Под ними отображается блок итоговой статистики спроса:
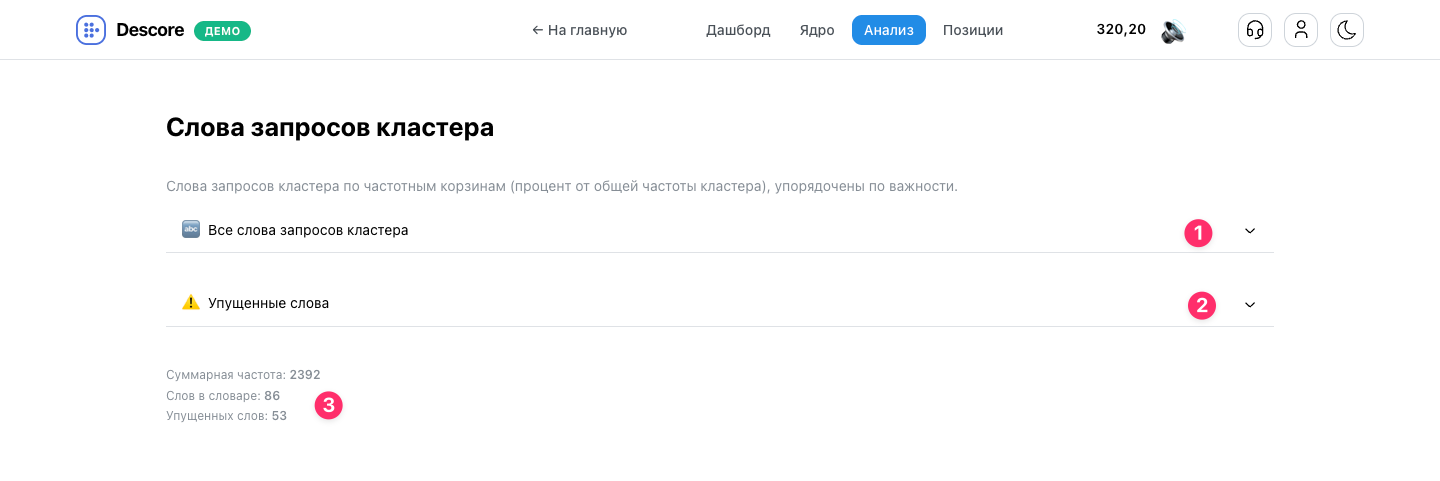
- 1 «🔤 Все слова запросов кластера» — раскрывает полный словарь запросов кластера по частотным корзинам.
- 2 «⚠️ Упущенные слова» — раскрывает слова запросов, отсутствующие в тексте посадочной страницы.
- 3 Блок статистики под аккордеонами — три ключевые метрики словаря спроса:
- Суммарная частота — сумма накопленных частот слов, прошедших порог 0.1% (
2392на скриншоте). Один запрос участвует в частотах нескольких слов, поэтому это число отличается от суммарной частотности запросов, используемой для расчёта процентов корзин. - Слов в словаре — общее количество уникальных лемм из запросов с частотной долей не менее 0.1% (
86на скриншоте). - Упущенных слов — число слов из этого словаря, не найденных в тексте посадочной страницы (
53на скриншоте).
Что означают частотные корзины (от 50% до 0.1%)
При раскрытии аккордеона «Все слова запросов кластера» отображаются частотные корзины:
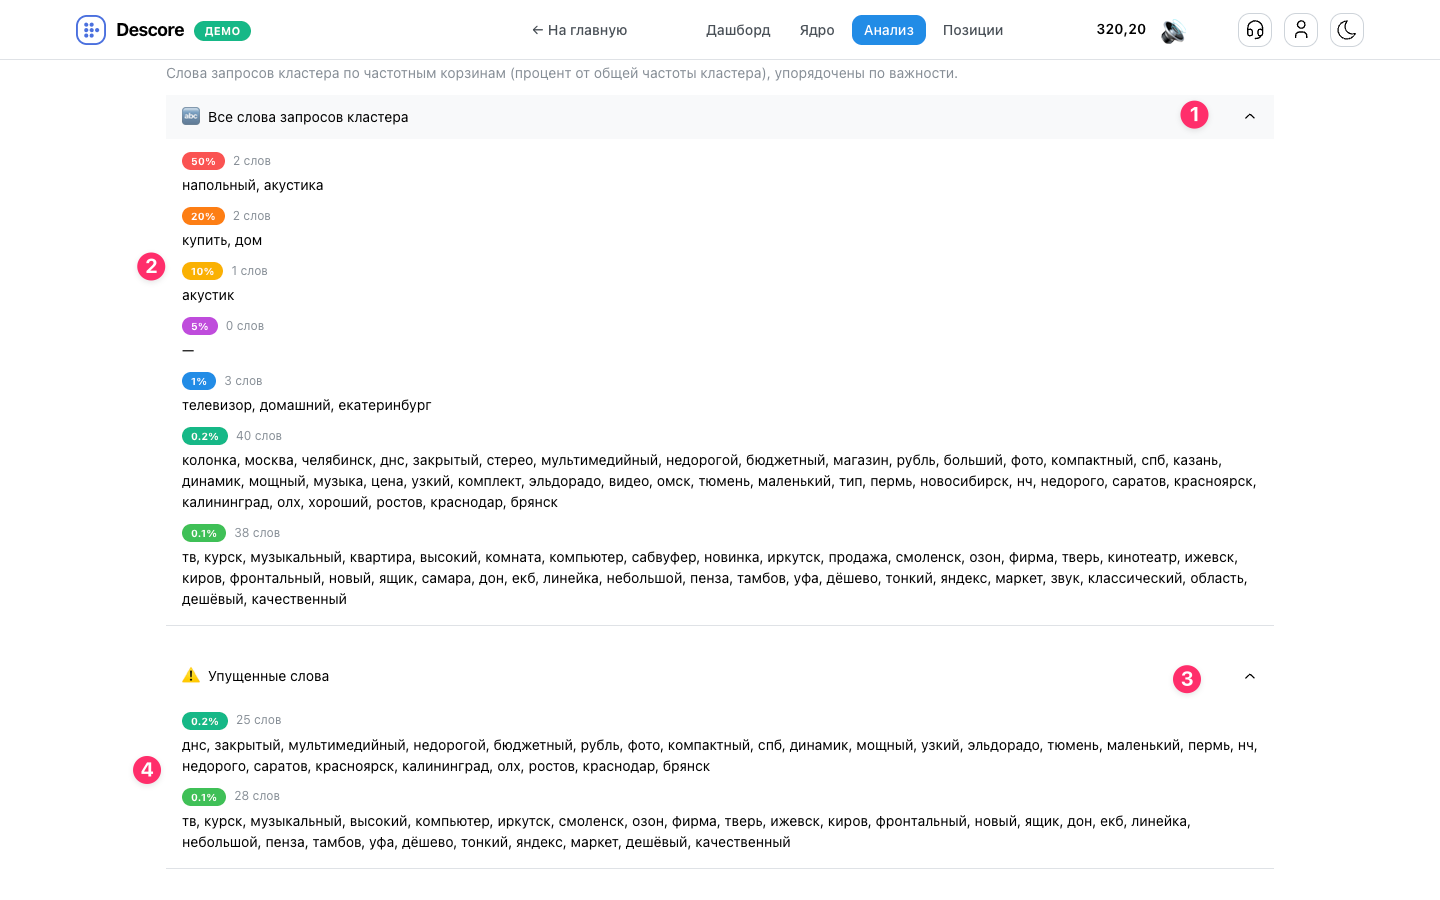
- 1 Аккордеон «Все слова запросов кластера» — содержит частотную иерархию.
- 2 Частотные корзины — бейдж обозначает диапазон доли слова от суммарной частотности запросов кластера.
Для расчёта доли слова сначала суммируется частотность запросов кластера:
Затем для каждой леммы складывается частотность её вхождений в запросы. Полученная частота слова F(w) делится на суммарную частотность запросов F_cluster:
Условный пример: «купить акустика» имеет частоту 100, «акустика доставка» — 50. Суммарная частота запросов равна 150. Частота слова «акустика» равна 150, «купить» — 100, «доставка» — 50; их доли составляют 100%, 66.7% и 33.3%. При этом плашка «Суммарная частота» показывает сумму частот слов: 150 + 100 + 50 = 300.
Повторные вхождения одной леммы в запрос учитываются отдельно. При отсутствующей или нулевой частотности текущий расчёт использует единичный вес. Доли разных слов могут относиться к одним и тем же запросам, поэтому их сумма не является долей независимого трафика.
Шкала разбита на фиксированные частотные интервалы, оформленные тепловой цветовой кодировкой бейджей (≥50% — красный, ≥20% — оранжевый, ≥10% — жёлтый, ≥5% — grape, ≥1% — синий, ≥0.2% — teal, 0.1% — зелёный):
- 50%: слова с долей не менее 50% суммарной частотности запросов кластера.
- 20% и 10%: доля от 20% до менее 50% и от 10% до менее 20% соответственно.
- 5% и 1%: доля от 5% до менее 10% и от 1% до менее 5% соответственно.
- 0.2% и 0.1%: доля от 0.2% до менее 1% и от 0.1% до менее 0.2% соответственно.
- Порог 0.1%: слова с меньшей частотной долей в этих списках не показываются. Каждое слово, прошедшее порог, попадает в одну корзину.
- Отображение пустых корзин: если в частотном интервале нет слов, Descore выводит
0 слови нейтральный прочерк—(как на демонстрационном скриншоте для корзины 5%).
Корзина показывает частотную долю слова. Какие именно слова входят в каждый диапазон, зависит от темы и состава запросов кластера. Их смысл и место использования на странице определяет специалист при разборе списка.
Внутри корзины леммы упорядочены по убыванию накопленной частотности. Для исходных словоформ и полных фраз обратитесь к списку запросов кластера.
Как работает блок «Упущенные слова»
Нижний аккордеон сопоставляет выявленный словарь спроса с очищенным контентом вашей посадочной страницы:
- 3 Аккордеон «⚠️ Упущенные слова» — клик раскрывает список пробелов посадочной страницы относительно поисковых запросов пользователей.
- 4 Корзины упущенных слов:
- Корзины без пропусков скрыты: если все слова из частотной корзины уже присутствуют в тексте посадочной страницы (на скриншоте это корзины 50%, 20%, 10% и 1%), эта корзина в списке упущенных полностью скрывается.
- Фокус на реальном дефиците: в интерфейсе выводятся только те группы, где обнаружены пропуски. В примере на скриншоте лендинг полностью закрыл верхние корзины и имеет пробелы только в длинном хвосте: 25 слов в корзине 0.2% и 28 слов в корзине 0.1%.
- Счётчик упущенных слов: сумма слов в видимых корзинах (25 + 28 = 53) совпадает с показателем «Упущенных слов: 53» в итоговой плашке под аккордеонами.
- Пустые состояния: при отсутствии групп полного словаря выводится
«Нет данных по словам запросов», при отсутствии групп пропусков —«Нет данных по упущенным словам». Пустой список пропусков возможен при отсутствии данных посадочной и при полном покрытии словаря; итоговый счётчик пропусков при этом может не отображаться. Если сама корзина пуста (как корзина 5%), выводится прочерк«—».
Рекомендации по доработке страницы
- Начните с корзин 50%, 20% и 10%. Посмотрите, какие слова из них отсутствуют на странице. Подумайте, можно ли добавить их в
Title,Description,H1или первый абзац. Некоторые слова могут подойти и для заголовковH2–H3. Если смысл слова непонятен, посмотрите запросы, в которых оно встречается. - Просмотрите остальные корзины — от 5% до 0.1%. Выберите слова, которые подходят вашей странице. Если неясно, зачем слово попало в список, посмотрите, в каких запросах его используют.
- Добавьте выбранные слова в текст. Для каждого слова найдите абзац или раздел, где о нём есть что сказать. Иногда достаточно уточнить фразу, а иногда стоит дописать объяснение.
- Проверьте результат. После правок нажмите «Обновить анализ». Посмотрите, какие слова исчезли из списка упущенных и как изменился кластерный BM25.
- Подготовьте ТЗ для копирайтера. Нажмите «Сгенерировать ТЗ» и выберите шаблон. В ТЗ попадут слова из корзин, включённых в этом шаблоне. Например, «Лайт» использует корзины 50%, 20%, 10% и 5%.
Частые вопросы
В чём принципиальное различие между блоком «Слова запросов кластера» и блоком «Покрытие»?
«Покрытие» анализирует тексты конкурентов в поисковой выдаче (SERP) и показывает процент сайтов, где встречается слово. «Слова запросов кластера» анализируют сами ключевые фразы кластера и показывают, какую долю суммарного поискового спроса Wordstat аккумулирует каждое слово. Покрытие отражает стандарт контента сайтов, а Слова запросов — формулировки реального спроса пользователей.
Почему корзины измеряются в процентах (50%, 20%, 10%...), а не в абсолютных числах частотности?
Суммарная частотность разных кластеров может сильно различаться. Процентная шкала показывает накопленную частоту слова относительно общей частоты запросов кластера. Это позволяет сравнивать частотные доли слов в кластерах разного масштаба.
Что означает строка с прочерком «—» (например, в корзине 5% на скриншоте)?
Если в интервале частотной доли (от 5.0% до 9.99%) ни одно слово запросов не набрало соответствующего веса, корзина отображается со счётчиком «0 слов» и символом «—». Это сохраняет непрерывность частотной шкалы.
Нужно ли добавлять на страницу все упущенные слова?
Отбирайте слова по теме и задаче страницы из любой корзины. Частотная доля помогает выбрать порядок проверки пропусков, а смысл слова и его уместность нужно оценить в контексте исходных запросов. Состав слов в каждой корзине зависит от конкретного кластера.
Как рассчитываются три числа в блоке статистики под аккордеонами?
«Суммарная частота» — сумма накопленных частот слов, прошедших порог 0.1% (2392 на скриншоте). Один запрос участвует в частотах нескольких слов, поэтому это число отличается от суммы частот запросов кластера. «Слов в словаре» — количество уникальных лемм с долей от 0.1% (86 слов). «Упущенных слов» — сколько из них отсутствует на посадочной (53 слова: 25 в корзине 0.2% и 28 в корзине 0.1%).
Учитываются ли слова с долей спроса менее 0.1% от суммарной частоты кластера?
Для этих списков задан порог 0.1%: слова с меньшей долей не показываются. Это порог частотного веса, а не проверка смысловой уместности слова.
Как блок «Слова запросов кластера» связан с метрикой «Кластерный BM25»?
Кластерный BM25 использует слова запросов с долей от 0.1%, их логарифмические частотные веса и распределение относительно длины текстовой зоны. После доработки страницы обновите анализ и сравните показатель вместе со списком пропусков.