

Метатеги и заголовки: анализ зон страницы и сниппетов топа
Раздел «Метатеги» детального отчёта сопоставляет формулировки ключевых зон посадочной страницы с лидерами поисковой выдачи: анализирует теги Title, H1, Description и подзаголовки H2–H3.
Для каждой зоны инструмент выявляет важные слова топа на основе взвешенного TF-IDF анализа и предоставляет раскрываемые таблицы полных текстов конкурентов с привязкой к позициям в SERP.
Где находится блок метатегов
В основном меню проекта перейдите в раздел «Анализ», откройте вкладку «Общий анализ» и кликните по имени интересующего кластера. В детальном отчёте прокрутите экран ниже графиков Z-метрик, метрик документов топа, Zipf-кривых и N-грамм до раздела «Метатеги».
Блок построен в виде четырёх независимых секций по ключевым текстовым зонам страницы. Каждая секция содержит перечень выявленных важных слов топа и разворачиваемый спойлер со сводной таблицей текстов всех проанализированных сайтов выдачи.
Блок показывает данные сохранённого анализа. После правок страницы нажмите «Обновить анализ», чтобы увидеть новые тексты.
Четыре зоны страницы и важные слова
Анализ разделяет данные на четыре зоны:
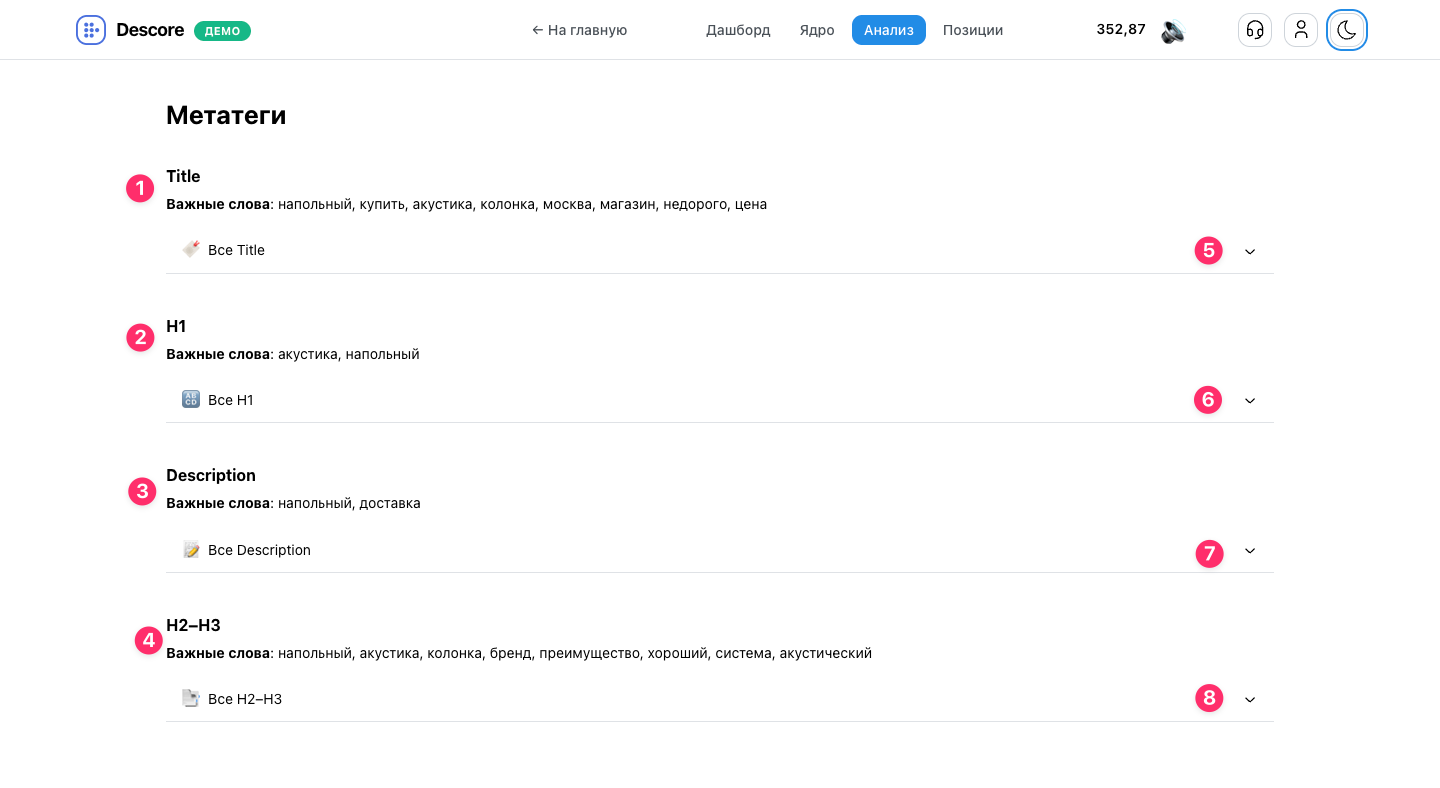
- 1 Секция Title — заголовок страницы во вкладке браузера и один из источников заголовка результата в поисковой выдаче. Под заголовком выводится строка «Важные слова»: леммы с наивысшим суммарным весом TF-IDF в топе выдачи (на скриншоте:
напольный, купить, акустика, колонка, москва, магазин, недорого, цена). - 2 Секция H1 — главный заголовок первого уровня контентной области страницы. Определяет основную тему документа без коммерческого переспама (на скриншоте:
акустика, напольный). - 3 Секция Description — мета-описание страницы, используемое алгоритмами поиска для формирования описательного сниппета при совпадении с интентом запроса. Отражает УТП и коммерческие триггеры (на скриншоте:
напольный, доставка). - 4 Секция H2–H3 — подзаголовки второго и третьего уровней, формирующие внутреннюю структуру статьи или каталога. Выявляет типичные рубрики контента лидеров ниши (на скриншоте:
напольный, акустика, колонка, бренд, преимущество, хороший, система, акустический). - 5 Спойлер «Все Title» — разворачивает полную таблицу заголовков Title по всем документам выдачи и посадочной странице проекта.
- 6 Спойлер «Все H1» — раскрывает сводную таблицу главных заголовков страниц топа.
- 7 Спойлер «Все Description» — раскрывает сводную таблицу мета-описаний.
- 8 Спойлер «Все H2–H3» — раскрывает сводную таблицу контентных подзаголовков страниц конкурентов.
Как Descore отбирает важные слова: TF-IDF и скор подзаголовков
Важные слова отбираются по весу TF-IDF, а для H2–H3 дополнительно учитывается распространённость в подзаголовках топа:
1. Алгоритм для зон Title, H1 и Description
Тексты каждой зоны очищаются от стоп-слов, союзов и предлогов, после чего приводятся к нормальным словарным леммам. Для всех документов топа вычисляется матрица TF-IDF. Суммарный вес каждого слова складывается по всей выдаче кластера:
В итоговую строку попадают леммы с суммарным показателем TF-IDF ≥ 1.0, отсортированные по убыванию веса. Благодаря этому на первые места выходят слова, сочетающие высокую частоту встречаемости у лидеров выдачи с тематической специфичностью для данного кластера.
2. Алгоритм для подзаголовков H2–H3 (комбинированный скор охвата)
Количество и объём подзаголовков у конкурентов различаются. Для общей зоны H2–H3 Descore использует скор, объединяющий средний TF-IDF слова и квадрат числа документов, в которых оно встречается:
| Компонент формулы | Пороговое условие | Назначение и логика работы |
|---|---|---|
DF (Document Frequency) | DF ≥ 2 | Количество документов топа, у которых слово найдено в подзаголовках H2 или H3. В список входят слова, встретившиеся хотя бы в двух документах. |
(DF)² (квадрат охвата) | Учёт распространённости | Квадрат охвата резко увеличивает приоритет слов, ставших нормой для большинства конкурентов (например, при DF = 5 множитель равен 25, а при DF = 2 — только 4). |
Средний TF-IDF | mean(TF-IDF > 0) | Среднее значение TF-IDF по положительным значениям на страницах, где слово встречается в подзаголовках. |
Итоговый Score | Score ≥ 0.5 | Минимальный порог отбора. Слова сортируются по убыванию скора, формируя готовый список тематических маркеров для проектирования разделов страницы (бренды, преимущества, характеристики). |
Сводные таблицы текстов конкурентов и посадочной
Клик по названию любого спойлера (например, «Все Title») разворачивает таблицу со всеми текстами, собранными со страниц выдачи:
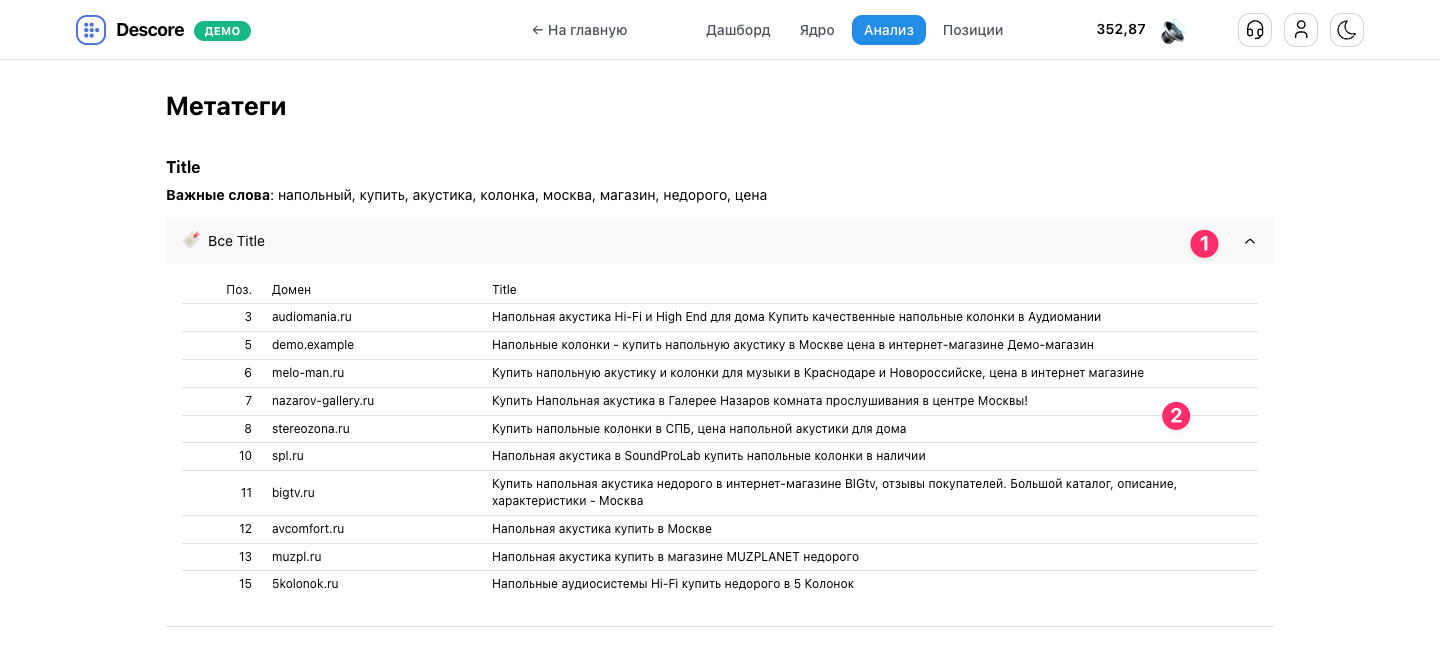
- 1 Переключатель состояния (шевроном вверх) — повторный клик по контролу сворачивает таблицу.
- 2 Реестр документов выдачи — структурированная таблица со следующими колонками:
- Поз. — позиция документа в органической поисковой выдаче на момент проведения анализа (на скриншоте:
3, 5, 6, 7, 8, 10, 11, 12, 13, 15). Число выровнено по правому краю. - Домен — чистый хост конкурента без префикса
www.(например,audiomania.ru,melo-man.ru,stereozona.ru). - Title (или H1 / Description / H2–H3) — полный оригинальный текст соответствующего тега или всех подзаголовков страницы (в зоне H2–H3 подзаголовки объединены через пробел).
Отображение вашей посадочной страницы
В таблице наглядно видно положение вашего сайта среди конкурентов:
- Лендинг входит в топ выдачи: посадочная страница проекта отображается на своей реальной позиции в общей таблице (на скриншоте проектный домен
demo.exampleзанимает 5-ю позицию с заголовком «Напольные колонки - купить напольную акустику в Москве цена в интернет-магазине Демо-магазин»). Строка выводится в общем порядке позиций без специальной цветовой подсветки — ориентируйтесь на домен сайта. - Лендинг проанализирован отдельно: если для посадочной получены метрики и она отсутствует в выборке топа, её строка добавляется в конец таблицы. При известной позиции отображается число, иначе — прочерк
—. - Диагностика пустых тегов: если текст зоны пуст в извлечённых данных, в ячейке выводится служебная отметка в квадратных скобках:
[Пустой title],[Пустой h1],[Пустое description]или[Пустые заголовки].
Таблицы показывают тексты, извлечённые из HTML страниц. Для проверки реального сниппета сравните его с текущей выдачей: поисковая система может сформировать заголовок и описание иначе.
Пустые состояния блока (Empty States)
- «Нет данных по метатегам» — отображается вместо секций зон при отсутствии блока метатегов в сохранённом анализе.
- Прочерк «—» в важных словах — выводится, если ни одно слово зоны не преодолело минимальный порог TF-IDF (≥ 1.0 для Title, H1, Description или скор ≥ 0.5 для H2–H3).
- «Нет данных» в таблице — отображается при раскрытии спойлера, если список текстов пуст.
Методика работы: оптимизация сниппетов и структуры
Данные блока «Метатеги» служат практическим ориентиром для составления ТЗ копирайтеру и ручной доработки сниппетов:
- 1. Сверка Title с топом выдачи — проверьте, входят ли слова из строки «Важные слова» в заголовок вашей страницы. Обратите внимание на паттерны лидеров (позиции 1–3): наличие коммерческих добавок («купить», «цена»), топонима («Москва») и название бренда магазина через разделитель.
- 2. Очистка H1 от поискового спама — сопоставьте свой H1 с конкурентами. В коммерческих нишах H1 обычно краток и точен («Напольная акустика», «Акустические системы»), в то время как искусственное перечисление городов и слов «купить недорого» в H1 часто приводит к переспаму.
- 3. Усиление привлекательности Description — изучите тексты конкурентов на предмет УТП: упоминают ли лидеры доставку, гарантию, наличие демонстрационного зала или количество моделей в каталоге. Сформулируйте сниппет с призывом к действию и ключевыми леммами из строки важных слов.
- 4. Проектирование структуры подзаголовков H2–H3 — используйте слова из зоны H2–H3 для формирования подразделов страницы: блоков преимуществ («преимущество»), подборок по производителям («бренд»), технических параметров («система», «акустический») и условий покупки.
- 5. Передача в генератор ТЗ и проверка рекомендаций — нажмите «Сгенерировать ТЗ» в верхней панели и выберите шаблон. Ключевые слова попадут в требования по тем зонам, которые включены в шаблоне. Для проверки вхождений по шаблону нажмите «Показать рекомендации» — откроется боковая панель.
Частые вопросы
Что означают «Важные слова» под названием каждой зоны?
«Важные слова» — это наиболее весомые леммы ниши, выявленные алгоритмом Descore среди документов поисковой выдачи по данному кластеру. Для зон Title, H1 и Description они ранжируются по суммарному весу TF-IDF (порог ≥ 1.0), отражая смысловые акценты и терминологический консенсус топа. Для подзаголовков H2–H3 используется скор с квадратом охвата сайтов (DF² · средний TF-IDF), выделяющий типовые тематические разделы ниши.
Почему подзаголовки H2 и H3 объединены в одну общую зону H2–H3?
Descore анализирует H2 и H3 как общую зону подзаголовков. Конкуренты могут оформлять похожие блоки на разных уровнях: один — через H2, другой — через H3 внутри секции. Общая зона позволяет сравнить лексику этих разделов.
Что означает запись [Пустой title] или [Пустое description] в таблице?
Отметки «[Пустой title]», «[Пустой h1]», «[Пустое description]» и «[Пустые заголовки]» означают, что в извлечённых данных соответствующий текст пуст. Если это неожиданно, проверьте страницу и результат её обработки.
Что отображается, если данных по метатегам нет или в зоне отсутствуют важные слова?
При отсутствии блока метатегов выводится «Нет данных по метатегам». Если в зоне нет слов, прошедших условия отбора, вместо списка важных слов отображается прочерк «—». Если раскрытая таблица пуста, выводится «Нет данных».
Где отображается моя посадочная страница, если она ещё не входит в топ-10?
Если посадочная входит в проанализированную выборку, её строка уже находится в общей таблице (на скриншоте demo.example занимает позицию 5). Если посадочная успешно проанализирована отдельно, её строка добавляется в конец: при известной позиции отображается число, иначе — прочерк «—». Строки выводятся без специальной цветовой подсветки.
Передаются ли выявленные важные слова метатегов в генератор ТЗ копирайтеру?
Да, если соответствующие зоны включены в выбранном шаблоне ТЗ. Например, «Лайт» включает важные слова Title и H1. Нажмите «Сгенерировать ТЗ» и проверьте состав шаблона перед генерацией.
Учитываются ли предлоги, союзы и знаки препинания в списке важных слов?
Нет. Перед расчётом текстовых метрик все исходные фрагменты проходят лингвистическую очистку: удаляются стоп-слова, предлоги («в», «на», «для», «под»), союзы и частицы, а слова приводятся к начальной форме (лемме). В список попадают лексические основы (существительные, прилагательные, глаголы), формирующие смысловой каркас страницы.