

Кривые Ципфа: распределение лексики топа
Раздел «Zipf-кривые» визуализирует структуру частотного словаря ключевых документов выдачи и сопоставляет её с посадочной страницей вашего проекта.
Закон Ципфа гласит, что частота слов в естественном языке убывает обратно пропорционально их рангу. Анализ кривых Ципфа позволяет сопоставить структуру словаря страницы с конкурентами: увидеть распределение частот ключевых слов, сравнить плотность лексики и оценить соответствие страницы диапазону выдачи.
Где находятся Zipf-кривые
Откройте «Анализ» в меню проекта, выберите вкладку «Общий анализ» и кликните по названию нужного кластера. В детальном отчёте прокрутите страницу ниже сводки, Z-блока и таблицы метрик документов до раздела «Zipf-кривые».
Блок состоит из панели переключения срезов данных, интерактивного линейного графика с чекбоксами выбора серий и подробной сводной таблицы со всеми проанализированными документами выдачи.
Вкладки срезов: Частота, Процент, TF-IDF и Лендинг
В зависимости от задач аудита вы можете исследовать распределение слов в разных плоскостях:
- «Частота» — показывает абсолютное количество вхождений каждого слова (приведённого к лемме, без стоп-слов) в тексте документов. В эталонный набор попадают лексемы с охватом не менее 70% сайтов топа, а слова на оси X отсортированы строго по убыванию медианной частоты в сохранённой выдаче.
- «Процент» — нормализует количество каждого слова относительно общего числа слов на странице. Этот режим устраняет погрешности, вызванные разным объёмом текстов (например, если у конкурента развёрнутый лонгрид, а у вас компактный каталог).
- «TF-IDF» — показывает долю слова с поправкой на размер словаря документа. Сопоставляйте её со значениями конкурентов и медианой топа, чтобы оценить различия в частотном профиле страниц.
- «Лендинг» — формирует срез по топ-20 словам вашей собственной посадочной страницы с переключателем «Частота / Процент» в правом верхнем углу панели. В отличие от первых трёх вкладок, ориентированных на словарь корпуса, эта вкладка строит график по топ-20 словам вашей страницы. Это позволяет увидеть слова, которые часто встречаются у вас, но отсутствуют в эталоне топа (например, повторяющиеся элементы каталога или название бренда), и сопоставить их с показателями конкурентов.
Интерактивный график распределения слов
График наглядно сопоставляет кривую частотности вашей посадочной страницы с медианой и границами топа выдачи.
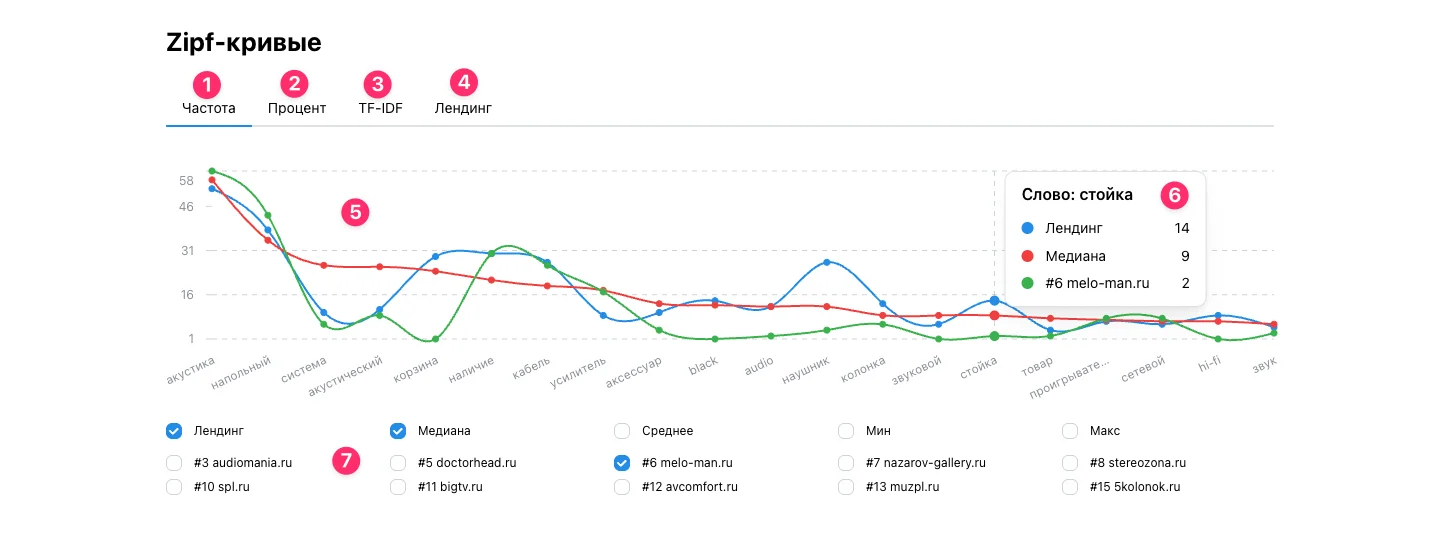
- 1 Вкладка «Частота» — срез абсолютных вхождений слов (без стоп-слов), ранжированных по убыванию медианы выдачи.
- 2 Вкладка «Процент» — нормализация частоты каждого слова относительно суммарного объёма документа.
- 3 Вкладка «TF-IDF» — доля слова, умноженная на логарифм числа уникальных слов документа, и сравнение этих значений с топом.
- 4 Вкладка «Лендинг» — персональный частотный топ слов вашей посадочной страницы (с переключателем «Частота / Процент»).
- 5 Линейный график — кривые распределения слов по рангу (по оси X отложены лексемы, по оси Y — значение показателя).
- 6 Подсказка точки (тултип) — при наведении курсора на любое слово показывает точные значения по всем включённым в данный момент линиям (например, для слова «стойка»: Лендинг — 14, Медиана — 9, конкурент #6 — 2).
- 7 Чекбоксы серий — управление линиями графика: эталонные ряды («Лендинг», «Медиана», «Среднее», «Мин», «Макс») и конкретные сайты выдачи (до 7 линий одновременно).
Сводная таблица по документам
Под графиком расположена подробная таблица с распределением значений по всем проанализированным документам выдачи.
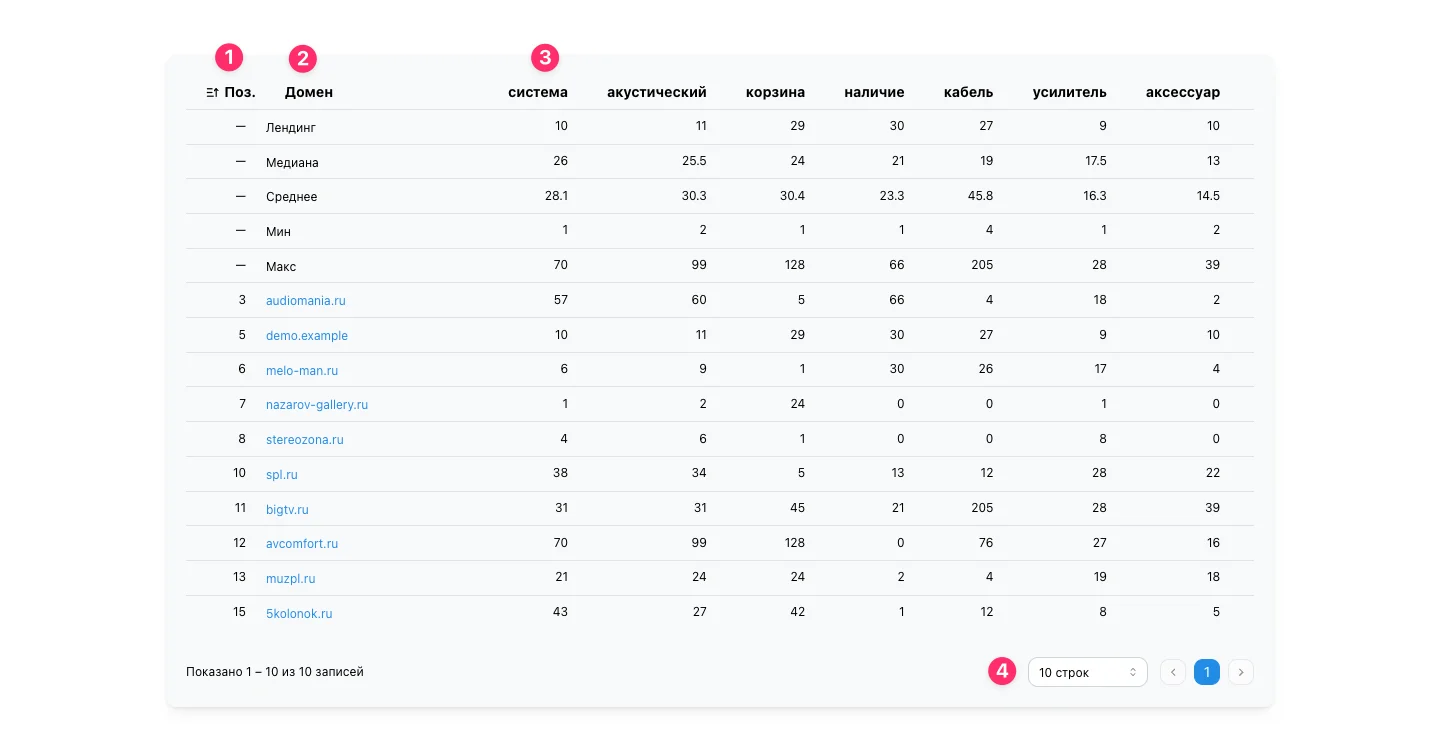
- 1 Колонка «Поз.» — позиция документа в сохранённой выдаче. Колонка зафиксирована слева при горизонтальной прокрутке. Клик по заголовку сортирует список сайтов по возрастанию или убыванию позиции.
- 2 Колонка «Домен» — доменное имя сайта конкурента с прямой внешней ссылкой на проанализированный URL страницы. Также закреплена слева при горизонтальном скролле. Клик по заголовку сортирует список по алфавиту. В верхней части таблицы закреплены сводные строки («Лендинг», «Медиана», «Среднее», «Мин», «Макс»). Если посадочная страница ранжируется в топе, она представлена и в сводной строке «Лендинг», и на своей позиции в выдаче.
- 3 Колонки слов — значения выбранной метрики для каждого слова. Список из 20 терминов ядра прокручивается по горизонтали. Клик по заголовку любого слова сортирует документы по значениям этой лексемы, позволяя быстро найти лидера по конкретному слову.
- 4 Пагинация и размер страницы — выбор отображения 10 или 20 строк и кнопки перехода между страницами таблицы.
Математика закона Ципфа в Descore
В основе модуля лежит лингвистический закон Джорджа Ципфа, описывающий баланс словаря в связных текстах: частота употребления слова обратно пропорциональна его порядковому номеру (рангу) в частотном списке. В логарифмических координатах степенная модель переходит в строго линейную функцию, к которой фактические частоты реального связного текста приближаются с тем или иным разбросом:
1. Экспонента Ципфа (s): концентрация лексики методом наименьших квадратов
Показатель степени s (Zipf Exponent) определяет крутизну спада частот и отражает концентрацию словаря на ядре ключевых терминов. Descore вычисляет его как абсолютное значение наклона линейной регрессии в координатах (ln r, ln f(r)) для топ-20 слов документа методом наименьших квадратов (МНК):
2. Индекс Zipf Compliance: взвешенное соответствие степенной модели
Для оценки гладкости рангового спада алгоритм сопоставляет фактические частоты каждого слова с теоретической гиперболой f̂(r) = f(1) / r, где константой выступает частота первого слова в топе документа. Затем рассчитывается взвешенное среднее относительное отклонение δ̄, в котором весом каждого ранга выступает его фактическая частота w_r = f(r) (чтобы высокочастотные термины ядра имели больший вес по сравнению с редкими словами на границе выборки):
| Показатель | Формула в коде | Практический смысл и влияние на качество текста |
|---|---|---|
Zipf Exponent (s) | abs(slope(ln f ~ ln r)) | Крутизна спада словаря. При s ≈ 1.0 распределение близко к стандартной степенной модели Ципфа. Значение s > 1.0 показывает выраженную концентрацию частот на нескольких первых словах, а s < 0.7 — более пологое распределение с равномерной повторяемостью лексики. |
Zipf Compliance (ZC) | 100 / (1 + δ̄ / 100) | Степень соответствия степенной модели (0–100%). Взвешивает отклонения с приоритетом верхних рангов ядра: 100% означает совпадение с теоретической гиперболой. Заметные отклонения отражают локальные перекосы в частотах первых слов (например, резкий отрыв главного слова или ступенчатый спад), но сами по себе не доказывают низкое качество или искусственность текста. |
Нормализация % | (freq / total_words) * 100 | Частота смысловой леммы делится на полный объём документа (включая служебные слова). Это позволяет объективно сопоставлять каталоги товаров и развёрнутые информационные статьи без искажения плотности терминов. |
Консенсус топа (70%) | min_doc_coverage = 0.7 | В эталонные срезы «Частота», «Процент» и «TF-IDF» включаются только слова, присутствующие минимум у 70% сайтов выдачи. Это отсекает редкие и узкоспецифичные термины отдельных страниц и выделяет устойчивое ядро ниши (при этом популярные бренды, представленные у большинства конкурентов, сохраняются в выборке). |
Метрики соответствия ZDDS: следование медианной кривой топа
Индексы ZC, ZDDS, ZPC и ZTC — это авторские расчётные метрики Descore, разработанные для сопоставления контента посадочной страницы со степенной моделью языка и эталонным профилем выдачи.
В то время как индекс Zipf Compliance (ZC) оценивает форму спада частот относительно теоретической гиперболы Ципфа, метрики семейства ZDDS (Zero-Deviation Document Score) вычисляют прямое арифметическое соответствие посадочной страницы эмпирической медианной кривой поисковой выдачи (ряду «Медиана» на графике выше).
Каждой вкладке интерактивного графика Zipf соответствует показатель следования медианному стандарту выдачи:
1. Вкладка «Частота» → ZDDS (Соответствие частотам топа)
Оценивает близость абсолютных вхождений 20 ключевых слов ядра выдачи на вашей странице к их медианам в топе. Логарифмическая дельта сглаживает единичные расхождения, а веса слов пропорциональны их суммарной медианной частоте в ядре. Максимальный штраф по отдельному слову ограничен 0.8, чтобы отсутствие одного второстепенного термина не обнуляло итоговую оценку страницы (из-за этого теоретический минимум заполненного документа составляет 20%, а 0% присваивается только при пустом тексте). При этом показатель отражает числовую плотность вхождений, а не смысловую полноту или качество аргументации:
2. Вкладка «Процент» → ZPC (Соответствие процентным долям)
Оценивает гармоничность плотности терминов в общем объёме текста. Формула нормирует отклонение на медианную долю слова в топе с добавлением сглаживающего эпсилона 0.1, исключая ложные перекосы из-за разницы в длине документов:
3. Вкладка «TF-IDF» → ZTC (Соответствие TF-IDF весам топа)
Сравнивает внутристраничные TF-IDF-веса терминов на вашей странице с медианными весами выдачи, нормируя разницу на максимум из двух значений:
| Вкладка графика | Метрика в отчёте | Что измеряет на графике и как интерпретировать |
|---|---|---|
«Частота» | ZDDS (20–100%) | Соответствие частотам топа. 100% означает точное совпадение числа вхождений с медианой топа, а нижняя планка 20% обусловлена защитным ограничением штрафа (δ ≤ 0.8). Если кривая лендинга лежит стабильно ниже медианы, основные термины ниши используются на странице реже медианного уровня выдачи. |
«Процент» | ZPC (0–100%) | Баланс процентных долей лексики. Показывает, насколько удельный вес ключевых терминов ядра в объёме страницы близок к медианам выдачи. Выявляет перекосы плотности: избыточную концентрацию слов либо их размытие относительно эталона топа. |
«TF-IDF» | ZTC (0–100%) | Соответствие внутристраничных TF-IDF-весов медианам конкурентов. Высокое значение означает, что доли выбранных терминов с учётом размера словаря страницы близки к медианным значениям топа. |
Форма кривой | ZC (0–100%) & s | Близость к модели f(1)/r. Показывает, насколько форма спада частот ядра текста соответствует теоретической гиперболе Ципфа независимо от состава слов у конкурентов. |
Практические ориентиры по графику
Сопоставление кривой посадочной страницы с эталонными рядами топа помогает объективно оценить баланс словаря:
- Коридор топа («Мин», «Медиана», «Макс») — показывает фактический диапазон частот у конкурентов из выдачи. В реальном поиске ранжируются страницы разного формата: от компактных витрин до подробных лонгридов. Линия «Медиана» служит ориентиром отраслевой нормы, а «Мин» и «Макс» очерчивают границы, в которых ранжируются лидеры ниши.
- Точки выше линии «Макс» — показывают слова, по которым плотность на вашей странице превышает показатели всех сайтов выдачи. Это не является автоматической ошибкой (например, если страница глубже раскрывает конкретный подраздел), но служит поводом переключиться на вкладку «Процент» и сопоставить частоту с общим объёмом текста.
- Значения на уровне линии «Мин» или нуля — показывают термины из ядра ниши (консенсус от 70% сайтов топа), которые на вашей странице почти не используются. Это прямой ориентир для контентных доработок: добавления недостающих характеристик, параметров выбора или тематических блоков.
- Слова с вкладки «Лендинг», отсутствующие в топе корпуса — первые три вкладки строятся строго по оси слов, характерных для большинства сайтов топа. Если на вашей странице часто повторяется слово, которого нет в ядре конкурентов (например, слово «купить» встречается 500 раз в кнопках каталога или название бренда дублируется в каждой карточке), на первых трёх вкладках оно попросту не появится, так как отсутствует на их оси X. Вкладка «Лендинг» строит ось по личному топ-20 вашей страницы, позволяя увидеть фактический список самых частых слов и оценить долю шаблонных повторов.
Частые вопросы
В чём практическая польза закона Ципфа для SEO-специалиста?
Закон Ципфа описывает эмпирическую закономерность распределения лексики в связном тексте: частота слов закономерно убывает с ростом их ранга. Сопоставление посадочной страницы с коридором топа («Мин», «Медиана», «Макс») позволяет быстро оценить пропорции словаря: найти слова с аномальной концентрацией на фоне конкурентов или, наоборот, выявить важные отраслевые понятия, которых на странице пока недостаточно.
Чем вкладка «Процент» отличается от вкладки «Частота»?
Вкладка «Частота» показывает абсолютное количество вхождений слова в штуках. Если на посадочной странице 3000 слов, а у конкурентов в среднем 1000, абсолютные частоты будут завышены естественным образом. Вкладка «Процент» нормализует частоту по отношению к общему объёму документа, позволяя сопоставить плотность слов независимо от разницы в объёме текста.
Зачем нужна отдельная вкладка «Лендинг»?
Первые три вкладки («Частота», «Процент» и «TF-IDF») показывают только топ-20 слов корпуса выдачи. Если на посадочной странице часто повторяется слово, которого нет в эталоне топа (например, слово «купить» встречается 500 раз в элементах каталога или сквозном меню), на первых трёх вкладках оно не появится на оси графика. Вкладка «Лендинг» строит график по собственному списку частых слов вашей страницы и показывает, сколько раз эти же слова встречаются у конкурентов.
Почему на графике можно одновременно включить не более 7 линий?
Ограничение связано с эргономикой визуализации. В системе задан общий пул из 7 контрастных цветовых маркеров, который распределяется между сводными рядами («Лендинг», «Медиана», «Среднее», «Мин», «Макс») и выбранными конкурентами. Каждая активная сводная серия занимает один слот: например, при включённых рядах «Лендинг» и «Медиана» остаётся до 5 слотов для сайтов топа. При исчерпании лимита оставшиеся чекбоксы конкурентов блокируются, пока вы не отключите одну из линий.
Как рассчитывается колонка TF-IDF для слов корпуса?
В этом блоке используется внутристраничный TF-IDF: доля слова в документе умножается на натуральный логарифм числа уникальных слов этой страницы. Высокое значение означает большую долю слова с учётом размера словаря документа. График и таблица позволяют сравнить эти значения у посадочной страницы и конкурентов.
Учитываются ли предлоги и союзы в кривых Ципфа?
Нет. Перед расчётом частот тексты очищаются от стоп-слов, союзов, междометий и предлогов, а значимые слова приводятся к начальной форме (лемме). В график и таблицу попадают леммы (существительные, прилагательные, глаголы), формирующие смысловое ядро тематики.