

N-граммы: устойчивые фразы топа и лендинга
Раздел «N-граммы» раскрывает фразовый профиль поисковой выдачи: показывает двухсловные (биграммы) и трёхсловные (триграммы) словосочетания, характерные для сайтов из топа, и сопоставляет их с текстом вашей посадочной страницы.
В отличие от анализа отдельных слов, N-граммы позволяют выявить реальные коллокации ниши — устойчивые конструкции, профессиональные термины и товарные формулировки, которые формируют контекстную релевантность документа.
Где находится блок N-грамм
В меню проекта откройте «Анализ», перейдите на вкладку «Общий анализ» и кликните по названию кластера. В детальном отчёте прокрутите страницу ниже Zipf-кривых до раздела «N-граммы».
Блок включает три взаимосвязанных представления: сводную агрегированную таблицу «Биграммы топа», параллельные таблицы биграмм и триграмм вашей посадочной страницы, а также разворачиваемый постраничный инспектор N-грамм по каждому документу конкурентов.
Как Descore извлекает N-граммы: пайплайн очистки и нормализации
Перед построением N-грамм текст проходит лингвистическую подготовку: изоляцию синтаксических блоков, лемматизацию, удаление стоп-слов и алфавитную нормализацию. Это исключает склейку фраз через границы предложений, устраняет шум предлогов и группирует перестановки слов в единые устойчивые коллокации ниши.
- 1. Сегментация по предложениям и DOM-блокам — текст делится на изолированные синтаксические сегменты. При этом алгоритм защищает точки в адресах («ул.», «г.», «д.»), единицах измерений («руб.», «шт.») и инициалах от ложного разрезания. Границы предложений и независимых DOM-блоков изолированы: слова из соседних фрагментов не склеиваются в N-граммы.
- 2. Токенизация и морфологическая лемматизация — слова приводятся к нижнему регистру и нормальной словарной форме (лемме) через морфологический анализатор. Например, формы «купил» и «купили» приводятся к лемме «купить», а сложные артикулы и марки оборудования (например, «rtx-4090» или «iphone-15») сохраняются без искажения дефисов.
- 3. Удаление стоп-слов и контактное сближение — из цепочки токенов исключаются предлоги («в», «на», «для», «под», «со»), союзы («и», «а»), частицы и междометия. Благодаря этому зависимые термины сближаются в контактное окно: например, фраза «стойка под акустику в Москве» превращается в плотную цепочку лемм
[стойка, акустика, москва]. - 4. Скользящее окно размера N — внутри каждого очищенного предложения окно шириной в 2 слова (биграмма) или 3 слова (триграмма) движется с шагом в одно слово, формируя все возможные непрерывные фразовые связки.
- 5. Каноническая алфавитная сортировка — слова внутри каждой полученной биграммы и триграммы сортируются по алфавиту (механика Unordered Bag-of-Words). Например, фразы «купить акустику» и «акустику купить» объединяются в общую биграмму «акустика купить», а триграммы приводятся к канонической связке (например,
[вч-динамика, диаметр, мм]). Это объединяет частоту устойчивой фразы независимо от порядка слов в предложении.
Пошаговый пример обработки текста
Наглядный пример того, как заголовок или текстовый фрагмент коммерческой страницы преобразуется в канонические биграммы:
| Этап конвейера | Состояние данных | Что делает алгоритм |
|---|---|---|
Исходный текст | «Купить напольную стойку под акустику в Москве!» | Сырой текстовый фрагмент документа |
1. Сегментация | ["Купить напольную стойку под акустику в Москве!"] | Выделяет границы предложений; предотвращает склейку со следующим блоком |
2. Лемматизация | [купить, напольный, стойка, под, акустика, в, москва] | Приводит каждое слово к словарной форме (лемме) в нижнем регистре |
3. Очистка предлогов | [купить, напольный, стойка, акустика, москва] | Удаляет стоп-слова («под», «в»); смысловые термины сближаются в контактную цепочку |
4. Скользящее окно (N=2) | (купить, напольный), (напольный, стойка), (стойка, акустика), (акустика, москва) | Формирует последовательные пары контактных лемм |
5. Каноническая нормализация | купить напольный, напольный стойка, акустика стойка, акустика москва | Сортирует леммы внутри пары по алфавиту: пара «(стойка, акустика)» сохраняется как «акустика стойка» |
Агрегированная таблица «Биграммы топа»
Основная таблица объединяет наиболее значимые двухсловные фразы, встречающиеся в сохранённой выдаче, и сравнивает плотность их употребления в топе с показателями вашей страницы.
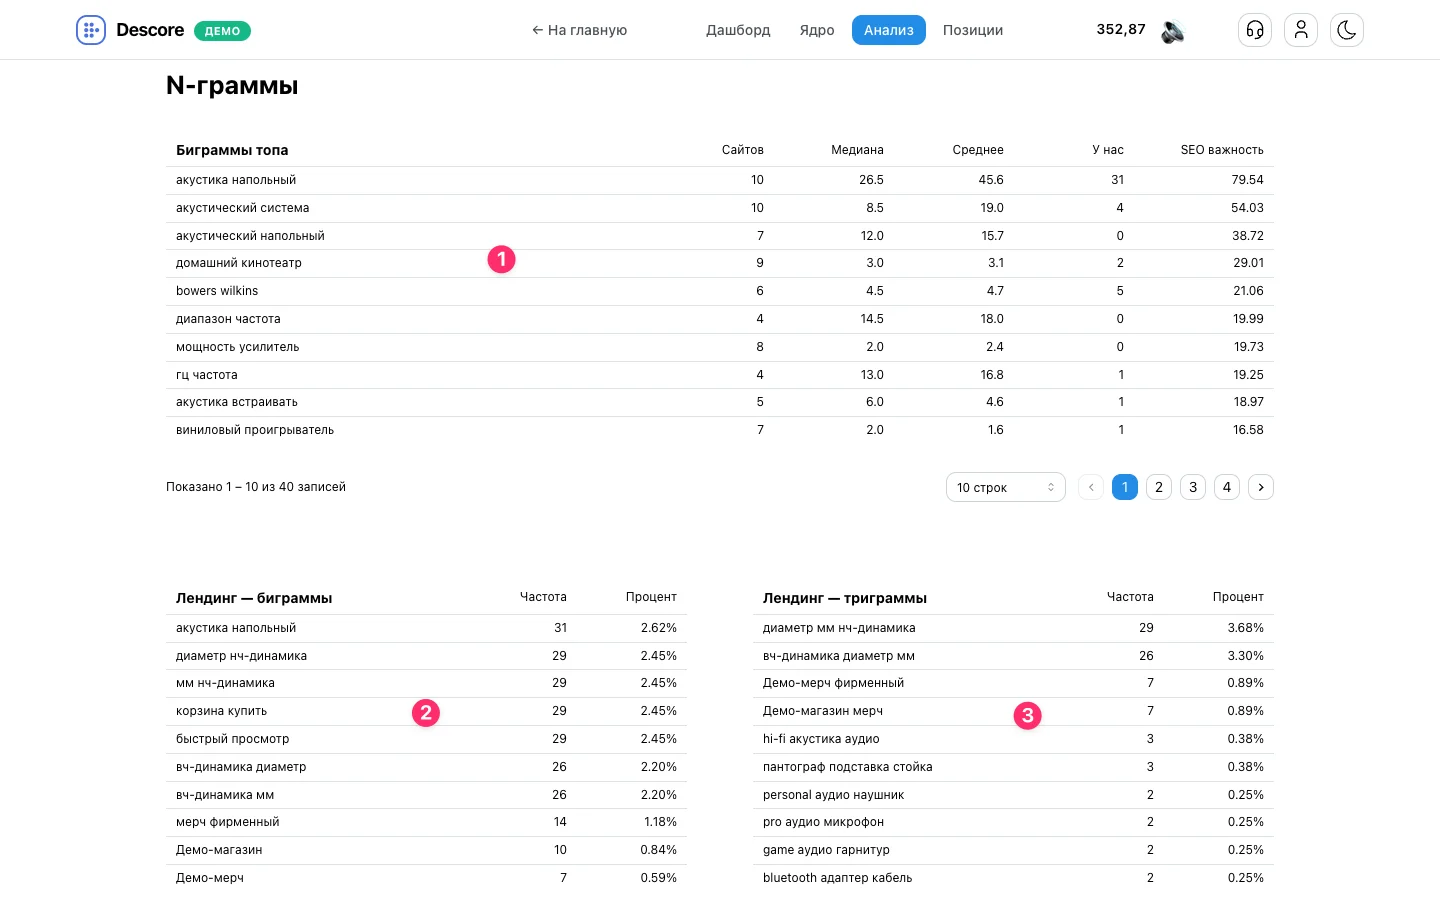
- 1 Таблица «Биграммы топа» — ключевые двухсловные сочетания ниши, отсортированные по показателю SEO-важности. Поддерживается выбор отображения по 10, 20 или 40 строк и пагинация страниц. Колонки таблицы:
- Биграммы топа — список двухсловных фраз, выявленных в текстах документов выдачи.
- Сайтов — количество сайтов из анализируемого топа, на которых найдена биграмма (охват ниши). Чем выше охват, тем обязательнее фраза для включения в контент.
- Медиана и Среднее — типичное и среднеарифметическое число употреблений биграммы на тех страницах выдачи, где она найдена.
- У нас — фактическое количество вхождений данной биграммы на вашей посадочной странице (значение 0 указывает на контентный пробел).
- SEO важность — интегральный показатель приоритета фразы, объединяющий медианную плотность и охват сайтов выдачи.
- 2 Таблица «Лендинг — биграммы» — топ-10 двухсловных фраз посадочной страницы. Колонка «Процент» рассчитывается как доля всех слов документа, занятых этой связкой:
(частота × 2) / total_words × 100%. - 3 Таблица «Лендинг — триграммы» — топ-10 трёхсловных фраз страницы с долей занятых слов в контенте:
(частота × 3) / total_words × 100%.
Формула показателя «SEO важность»
Ранжирование фраз в таблице «Биграммы топа» строится не по простой суммарной частотности, которая поощряет искусственный переспам, а по сбалансированному показателю SEO-важности. Формула объединяет логарифмическую медианную плотность фразы и её охват среди сайтов выдачи:
Если словосочетание встречается менее чем на 10% сайтов выдачи (охват ≤ 10%), оценка принудительно обнуляется, что исключает случайный лексический шум единичных страниц.
| Компонент | Значение в Descore | Смысл в SEO и влияние на ранжирование |
|---|---|---|
K (score_scale) | 24.0 | Масштабирующий коэффициент для оценки в баллах. Итоговое значение может превышать 100. |
ln(1 + Median) | math.log1p(median_freq) | Медианное число употреблений фразы среди сайтов, где она найдена. Логарифм задаёт убывающую отдачу: первые вхождения дают основной прирост скора, а накрутка частоты на одной странице не даёт аномального преимущества. |
(Sites / Total)^γ | γ = 1.3 (coverage_gamma) | Охват ниши. Доля сайтов выдачи, использующих фразу, возводится в степень 1.3: благодаря этому широта охвата доминирует над голой частотой. Фраза, встретившаяся у 10 конкурентов по 2 раза, ранжируется выше фразы с одного сайта с 20 повторами. |
Фильтр шума | coverage > 10% | Автоматическое отсечение редких и узкоспецифичных фраз, не отражающих консенсус поисковой выдачи. |
Анализ фраз посадочной страницы
Две параллельные таблицы под основной сводкой фиксируют собственный профиль устойчивых словосочетаний вашей страницы. Они решают две ключевые задачи:
- Обнаружение шаблонного мусора — если верхние строчки занимают сервисные конструкции интернет-магазина («корзина купить», «быстрый просмотр», повторы названий брендов), страница перегружена техническим текстом или содержит недостаточно полезного описательного контента.
- Проверка целевых словосочетаний — анализ триграмм позволяет увидеть, в каких именно связках используются ключевые слова (например, «стойка под акустику», «комплект акустических стоек»), и выявить тавтологии или неестественные повторы.
Инспектор N-грамм документов топа
Ниже основных таблиц расположен сворачиваемый блок «🧩 N-граммы всех документов топа». Он позволяет детально исследовать текстовую структуру любого отдельного конкурента из выдачи.
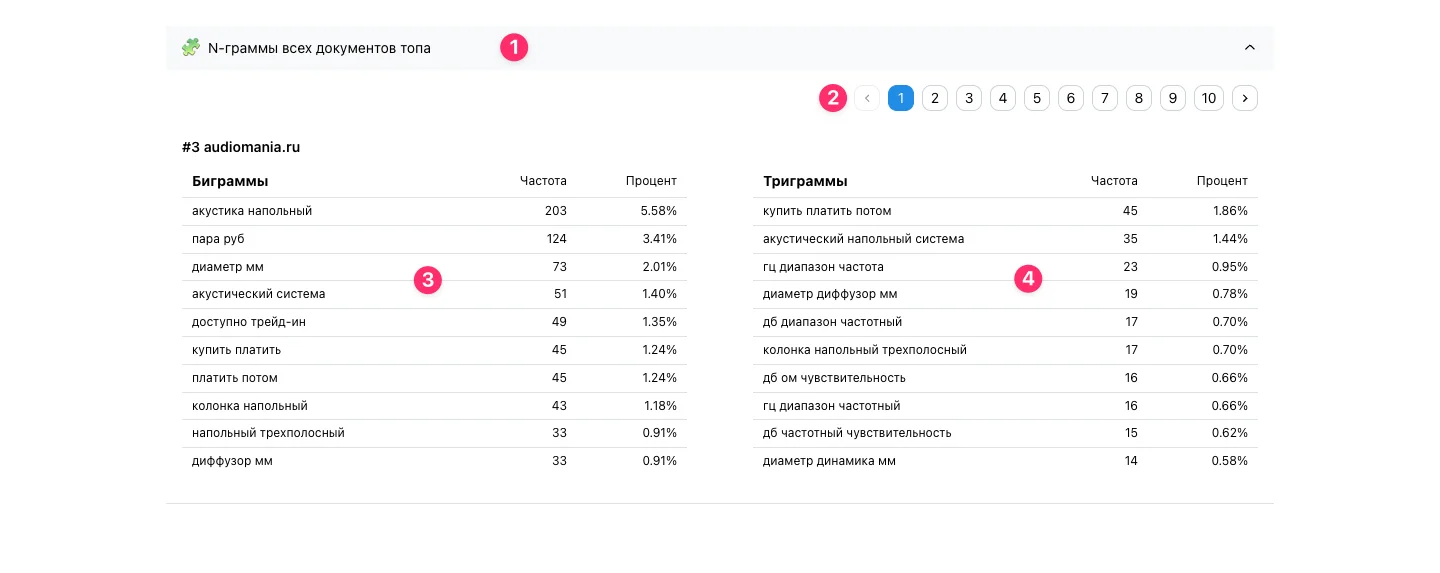
- 1 Спойлер «🧩 N-граммы всех документов топа» — клик по заголовку разворачивает панель инспектора.
- 2 Пагинатор документов — кнопки переключения страниц (1 2 3 ... 10) листают конкурентов по одному сайту на страницу в порядке их позиций в выдаче (страница 1 — позиция #1 или лидер сохранённого топа, страница 2 — следующий документ).
- 3 Таблица «Биграммы» — топ-10 двухсловных фраз выбранного конкурента с указанием их абсолютной частоты и процента на странице.
- 4 Таблица «Триграммы» — топ-10 трёхсловных фраз выбранного сайта с их частотой и процентной долей в тексте документа.
Методика работы: gap-анализ и ТЗ
Использование блока N-грамм позволяет составить точечный план доработки текстового содержания страницы:
- Шаг 1. Поиск упущенных фраз (Gap Analysis) — в таблице «Биграммы топа» отберите фразы с высоким показателем SEO-важности и охватом от 60–70% сайтов, у которых в столбце «У нас» стоит значение 0. Это наиболее приоритетные кандидаты для добавления в текст.
- Шаг 2. Анализ медианного ориентира — для каждой упущенной биграммы ориентируйтесь на значение из колонки «Медиана». Не стоит многократно повторять фразу: достаточно включить её столько раз, сколько в среднем используют сайты топа (обычно 2–5 вхождений).
- Шаг 3. Заимствование триграмм для структуры — изучите триграммы лидеров выдачи (например, первого документа на позиции #3) через инспектор документов. Трёхсловные конструкции отлично подходят для формулирования тематических подзаголовков H2/H3, названий таблиц характеристик и списков преимуществ.
- Шаг 4. Контроль переспама — сопоставьте собственные биграммы с топом. Если у вас фраза встречается 15–20 раз, а медиана топа составляет всего 3–4, снизьте плотность повторов во избежание текстовых санкций за переоптимизацию.
Частые вопросы
Что такое N-граммы и чем они отличаются от отдельных ключевых слов?
N-грамма — это непрерывная цепочка из N слов в тексте документа: биграмма состоит из 2 слов («акустическая система», «купить стойку»), а триграмма — из 3 слов («стойка под акустику», «напольная акустическая система»). В Descore перед построением N-грамм текст очищается от предлогов и союзов, а слова приводятся к леммам и упорядочиваются по алфавиту: благодаря этому фразы объединяются в устойчивые коллокации (например, «акустика напольный», «корзина купить»), не распыляя статистику из-за перестановок слов или падежей. Поисковые алгоритмы оценивают не только вхождения отдельных слов, но и естественную фразовую связность контента.
Как рассчитывается показатель «SEO важность» в таблице биграмм?
Показатель рассчитывается по формуле насыщения и охвата: K · ln(1 + медиана) · (охват)^gamma. Охват сайтов ниши доминирует над голой частотой, а фразы с присутствием менее чем на 10% сайтов отсекаются как шум. Полная формула с интерактивным разбором параметров приведена в отдельном разделе выше.
Что делать, если в колонке «У нас» стоит 0 при высокой SEO-важности?
Это прямой признак контентного пробела (content gap). Если устойчивое словосочетание встречается у 7–9 из 10 лидеров выдачи, но полностью отсутствует на вашей странице, поисковая система может счесть документ недостаточно релевантным или неполным. Рекомендуется внедрить данную фразу в основной текст, подзаголовки H2/H3 или карточки товаров в количестве, близком к медиане топа.
Почему в таблицах лендинга встречаются фразы вроде «корзина купить» или «быстрый просмотр»?
Алгоритм анализирует весь текстовый контент страницы, включая сквозные интерфейсные блоки интернет-магазина (кнопки заказа, корзина, меню). Предлоги отсекаются стоп-листом, слова приводятся к леммам и сортируются внутри пары: например, «добавить в корзину» даёт биграмму «добавить корзина», а соседние леммы «купить» и «корзина» — «корзина купить». Если такие технические фразы занимают верхние строчки по проценту вхождения, это повод проверить соотношение полезного описательного текста и шаблонного интерфейсного мусора.
Можно ли скопировать N-граммы конкурентов для составления ТЗ копирайтеру?
Да. Вы можете использовать инспектор конкурентов под спойлером для детального анализа лидеров выдачи или воспользоваться встроенным инструментом «Генерация ТЗ», который автоматически включает ключевые биграммы и триграммы с рекомендуемым числом вхождений в готовое задание.
Сколько всего биграмм анализируется для одного кластера?
В агрегированную таблицу топа попадает до 40 наиболее значимых биграмм, отранжированных по убыванию SEO-важности. В инспекторе конкретных документов отображаются персональные топ-10 биграмм и топ-10 триграмм выбранной страницы.