

Покрытие: семантика корпуса топа и упущенные слова
Раздел «Покрытие» детального отчёта группирует слова из документов топа выдачи по доле документов, в которых они встречаются (от 100% до 40%), и сопоставляет этот словарь с текстом посадочной страницы проекта.
Инструмент показывает лексический срез поисковой ниши и автоматически находит упущенную LSI-семантику — слова, присутствующие у большинства лидеров выдачи, но забытые на вашей посадочной странице.
Где находится блок покрытия
В основном меню откройте «Анализ» → вкладка «SERP» и нажмите на название кластера. В детальном отчёте прокрутите экран ниже графиков Z-метрик, метрик документов топа, Zipf-кривых, N-грамм и Метатегов до раздела «Покрытие».
Блок расположен перед блоком «Слова запросов кластера» и состоит из двух независимых аккордеонов.
Списки относятся к сохранённому анализу. После изменения страницы нажмите «Обновить анализ», чтобы проверить обновлённый текст.
Зачем нужен анализ покрытия корпуса топа
Корпус топа — это тексты проанализированных страниц выдачи. Общая лексика помогает сравнить словарь страницы со словами конкурентов и определить, какие аспекты темы стоит рассмотреть при её доработке.
Блок «Покрытие» решает три ключевые задачи специалиста:
- Лексика ниши: слова сгруппированы по встречаемости у конкурентов — от общего словаря (100%–90%) до терминов, встречающихся в части документов (80%–40%).
- Автоматический gap-анализ посадочной страницы: избавляет от многочасового ручного чтения сайтов конкурентов. Система мгновенно сопоставляет словарь лидеров выдачи с текстом вашей страницы и формирует готовый список дефицитных лемм.
- Фокус на распространённых словах: в списках показываются слова, найденные хотя бы в 40% документов топа.
Структура блока: корпус и упущенная семантика
В исходном состоянии оба аккордеона свёрнуты, чтобы не загромождать отчёт длинными списками слов:
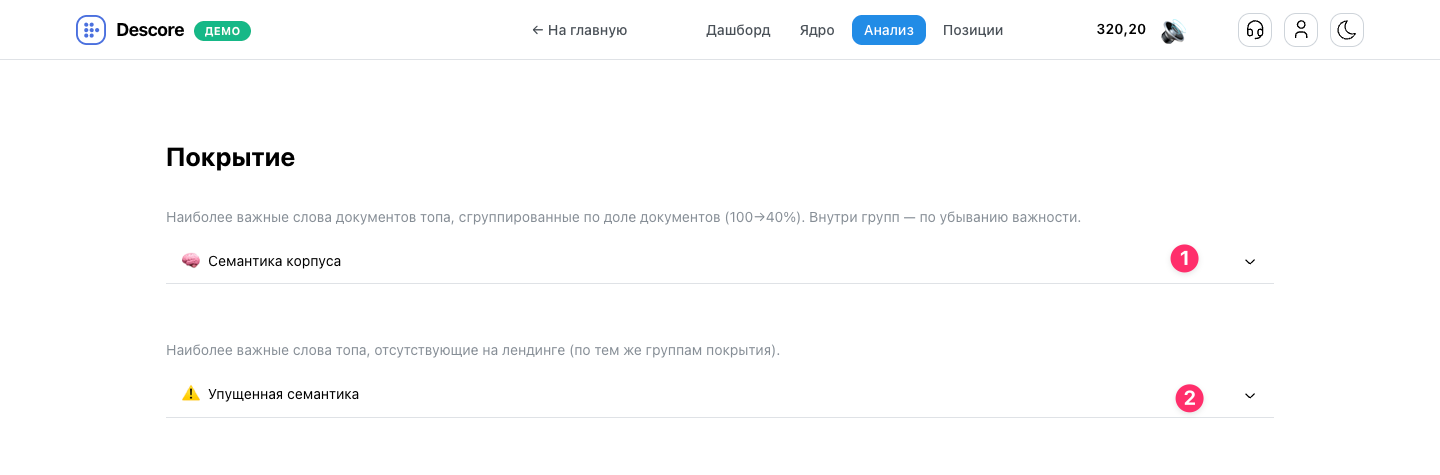
- 1 «🧠 Семантика корпуса» — раскрывает полный словарь документов топа выдачи, разбитый по группам охвата (100→40%).
- 2 «⚠️ Упущенная семантика» — раскрывает список слов топа, которых нет в очищенном тексте вашей посадочной страницы.
Что означают проценты покрытия (100%–40%)
Клик по аккордеону «Семантика корпуса» разворачивает словарь топа по семи корзинам охвата:
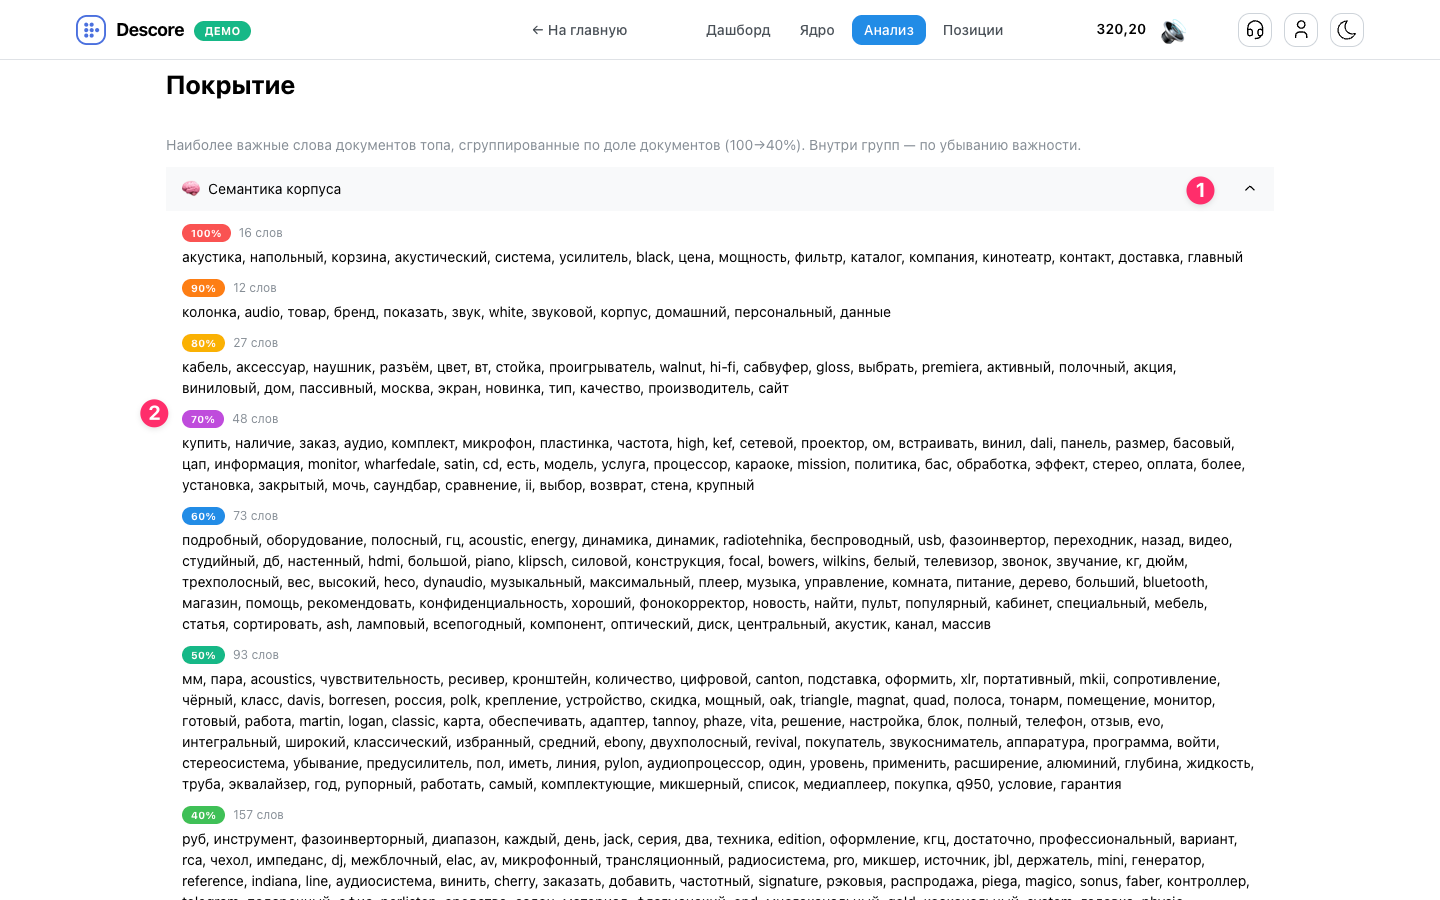
- 1 Заголовок аккордеона с шевроном — клик сворачивает и разворачивает список.
- 2 Группы покрытия (100% → 40%) — процент на бейдже показывает долю документов топа, в тексте которых встречается слово:
где DF(w) — количество документов сохранённого топа, содержащих лемму w, а N_docs — общий объём проанализированной выдачи по кластеру.
Процент на бейдже — нижняя граница группы. Например, группа 80% включает значения от 80% до менее 90%. При десяти документах 8 из 10 дают ровно 80%. Если документов двадцать, 19 из 20 дают 95% — слово попадёт в группу 90%.
Шкала разбита на семь фиксированных диапазонов с шагом 10%, оформленных тепловым цветовым градиентом от более горячих к холодным (100% — красный, 90% — оранжевый, 80% — жёлтый, 70% — grape, 60% — синий, 50% — teal, 40% — зелёный):
- 100%: слова, которые присутствуют в каждом проанализированном документе топа (например, 10 из 10 документов).
- 90%: слова с покрытием от 90% до менее 100% документов (например, 9 из 10).
- 80% и 70%: покрытие от 80% до менее 90% и от 70% до менее 80% документов соответственно (8 и 7 из 10).
- 60% и 50%: покрытие от 60% до менее 70% и от 50% до менее 60% документов соответственно (6 и 5 из 10).
- 40%: покрытие от 40% до менее 50% документов (например, 4 из 10).
- Порог 40%: слова с меньшей встречаемостью в этих списках не показываются. Смысловую уместность терминов оценивайте по теме и содержанию страницы, в том числе в верхних группах.
Процент показывает, насколько часто слово встречается в документах топа. Состав каждой группы зависит от темы и выбранных страниц выдачи. Смысл слова и место его использования на странице определяет специалист при разборе списка.
Каждая группа оформлена бейджем с процентом охвата и счётчиком уникальных лемм. Внутри группы слова отсортированы по убыванию среднего внутристраничного TF-IDF на страницах, где они встречаются:
Внутристраничный TF-IDF равен доле слова в тексте, умноженной на натуральный логарифм числа уникальных слов страницы. Среднее берётся по страницам, содержащим слово: например, значения 0.1 и 0.2 дают 0.15. Чем выше средний вес, тем раньше слово в списке; смысловую уместность термина оценивает специалист.
Как работает блок «Упущенная семантика»
Клик по аккордеону «Упущенная семантика» разворачивает автоматический аудит расхождений между словарем лидеров выдачи и текстом вашей посадочной страницы:
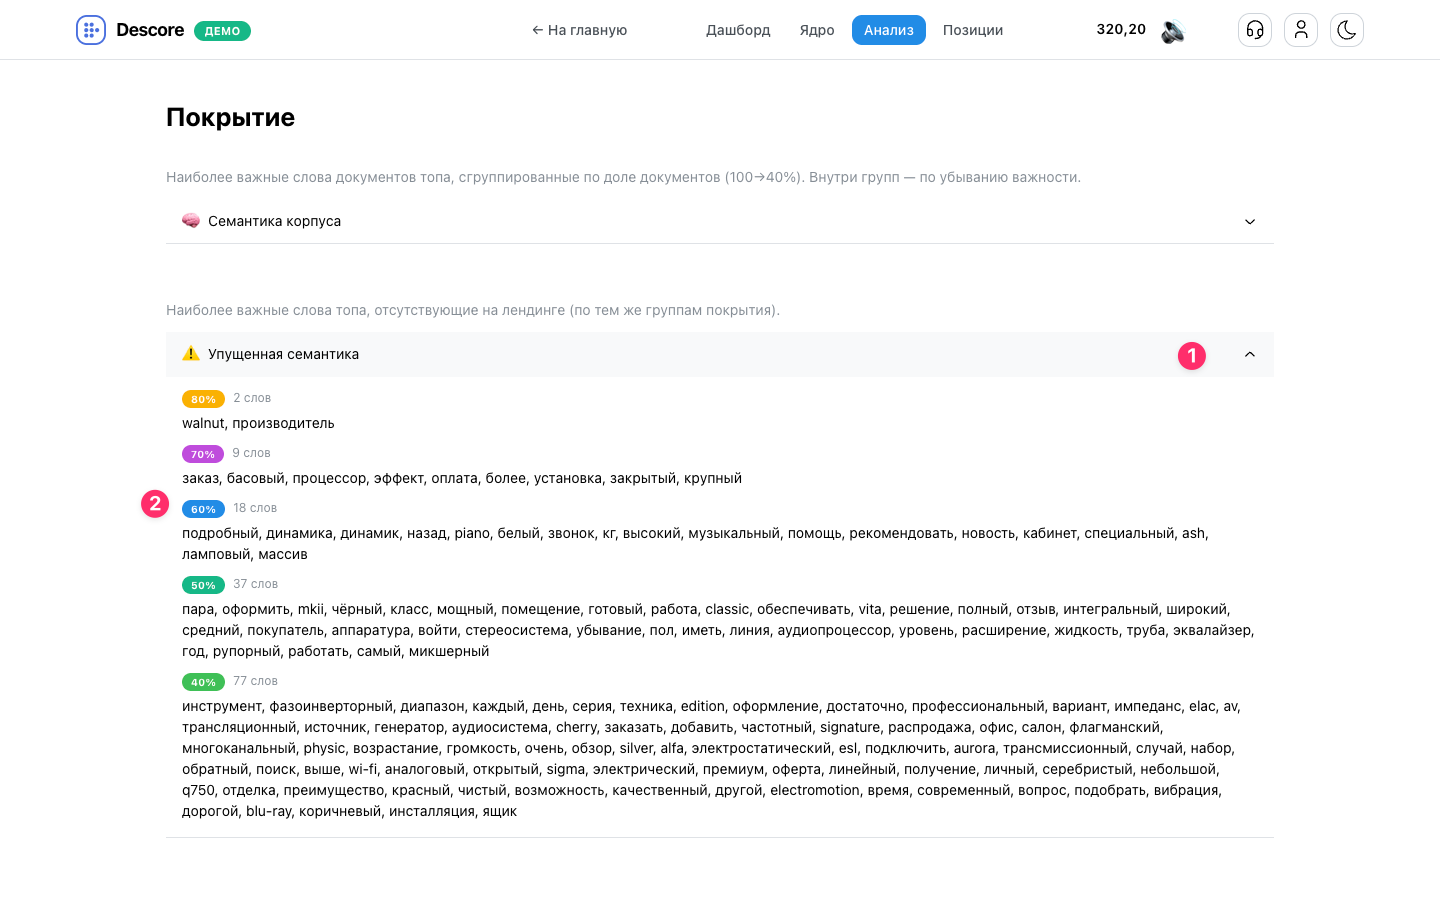
- 1 Заголовок аккордеона «Упущенная семантика» — клик раскрывает перечень пробелов посадочной страницы.
- 2 Группы отсутствующих слов — отображают только те уровни охвата, где у страницы обнаружен реальный дефицит лексики:
- Алгоритм сопоставления: исходный HTML-код вашей посадочной страницы очищается от скриптов, стилей и служебных тегов. Полученный текст проходит морфологический разбор: слова приводятся к начальной форме (лемме), отсекаются общие стоп-слова, предлоги и союзы. Затем полученный набор лемм поэлементно сравнивается со словарем корпуса топа.
- Группы без пропусков скрыты: если посадочная страница уже содержит все леммы из группы 100% или 90%, эти строки в интерфейсе полностью скрываются. На демонстрационном скриншоте группы 100% и 90% закрыты на 100%, поэтому первой строкой выводится группа 80%.
- Счётчик слов: рядом с бейджем процента указано количество отсутствующих лемм. На скриншоте в группе 80% два слова: walnut, производитель. Проверьте, относятся ли они к ассортименту и содержанию вашей страницы.
- Пустые состояния и прочерки: при отсутствии групп выводится
«Нет данных по покрытию»или«Нет данных по упущенной семантике». Пустой список пропусков возможен при отсутствии данных посадочной и при полном покрытии словаря. Проверьте доступность анализа лендинга. В пустой группе вместо перечня выводится прочерк«—».
Рекомендации по доработке страницы
- Начните с групп 100% и 90%. Посмотрите, какие слова из них отсутствуют на странице. Подумайте, можно ли добавить их в
Title,Description,H1или первый абзац. Если смысл слова непонятен, посмотрите, как его используют на страницах топа. - Затем посмотрите группы 80% и 70%. Часть этих слов может подойти для заголовков
H2–H3или текста под ними. Выберите те, о которых есть что сказать на вашей странице. - Просмотрите группы 60%–40%. Выберите слова, которые подходят вашей странице. Если неясно, зачем слово попало в список, посмотрите, как его используют конкуренты.
- Добавьте выбранные слова в текст. Для каждого слова найдите абзац или раздел, где о нём есть что сказать. Иногда достаточно уточнить фразу, а иногда стоит дописать объяснение.
- Подготовьте ТЗ для копирайтера. Нажмите «Сгенерировать ТЗ» и выберите шаблон. В tz.md и validate.md попадут группы покрытия, включённые в этом шаблоне. Например, «Лайт» использует группы 70–100%. Подробнее — в руководстве по генерации ТЗ.
Частые вопросы
В чём разница между блоком «Покрытие» и блоком «Слова запросов кластера»?
«Покрытие» анализирует тексты документов конкурентов из топа выдачи (SERP) и считает процент сайтов, в которых встречается слово (Document Frequency). Блок «Слова запросов кластера» анализирует сами поисковые запросы кластера и считает долю слова от их суммарной частотности Wordstat. Покрытие показывает лексический стандарт документов выдачи, а Слова запросов — формулировки поискового спроса пользователей.
Почему диапазон покрытия ограничен 40% и нет корзин 30%, 20% или 10%?
Для этого блока задан порог 40% документов топа. Слова с меньшей встречаемостью не попадают в показываемый словарь. Уместность слов любой группы зависит от темы и содержания вашей страницы.
Почему в блоке «Упущенная семантика» могут отсутствовать корзины 100% или 90%?
Если посадочная страница уже содержит все слова из этих групп топа, пустые корзины в списке упущенных слов скрываются. Система сразу фокусирует внимание на тех диапазонах, где у страницы есть реальный дефицит лексики.
Учитываются ли формы слов (падежи, окончания, числа)?
Все слова приводятся к словарным основам (леммам) с исключением стоп-слов, союзов и предлогов. Если на странице использована любая грамматическая форма слова (другое число или падеж), лемматизатор сопоставит её с основой, и слово не будет ошибочно отмечено как упущенное.
Что отображается в блоке, если посадочная страница ещё не создана или не привязана?
Секция «Семантика корпуса» работает в обычном режиме и позволяет изучить словарь документов топа до написания текста. В секции «Упущенная семантика» при этом выводится статус «Нет данных по упущенной семантике».
Передаются ли упущенные слова покрытия в модуль генерации технического задания?
В ТЗ и проверочные требования попадают группы покрытия, включённые в выбранном шаблоне. Например, «Лайт» использует группы 70–100%. Нажмите «Сгенерировать ТЗ» и выберите шаблон с нужными группами.