

Скопировать для агента: подготовка контекста для ИИ
Функция «Скопировать для агента» копирует в буфер обмена данные кластера: целевой URL посадочной страницы, название, суммарную частотность и список слов с их частотами и входящими поисковыми запросами.
Зачем нужны частоты у слов и вложенные запросы:
- Частоты слов задают приоритеты: слова с максимальным спросом выносят в Title, H1 и Description, а менее частотные — распределяют по подзаголовкам H2–H3 и тексту страницы;
- Входящие запросы показывают реальные формулировки пользователей: по ним видно, в каких устойчивых связках и падежах слова реально запрашивают в поиске;
- URL фиксирует адрес посадочной страницы: контент и метатеги формируются сразу под конкретный раздел сайта.
Скопированный текст вставляют в промпт нейросети, чтобы перенести семантику всех запросов кластера на посадочную страницу и в метатеги. В платформе доступно два варианта копирования: пакетный для группы кластеров из таблицы структуры и точечный для выбранных слов из окна «Анализ слов».
Два варианта копирования: когда какой использовать
В зависимости от текущей задачи можно выгрузить полный контекст по группе посадочных страниц или точечный срез лексем:
- Вариант 1 (снаружи — таблица структуры): используется для пакетного создания метатегов (Title, Description, H1), составления полного ТЗ на копирайтинг с нуля или анализа группы посадочных страниц каталога (до 200 кластеров). В буфер попадают URL посадочной, заголовок кластера, общая частотность и частотный словарь лексем с примерами до 3 ключевых фраз на слово.
- Вариант 2 (изнутри — модальное окно «Анализ слов»): используется для доработки уже готового текста, насыщения статьи LSI-лексемами, интеграции коммерческих маркеров («купить», «цена», «москва») или добавления технических параметров. Пользователь вручную отмечает только нужные слова и фразы.
Вариант 1. Пакетный контекст кластеров (снаружи, из таблицы структуры)
Перейдите в модуль «Ядро» на вкладку «Кластеры». Выберите чекбоксами строки нужных посадочных страниц и откройте выпадающее меню действий.
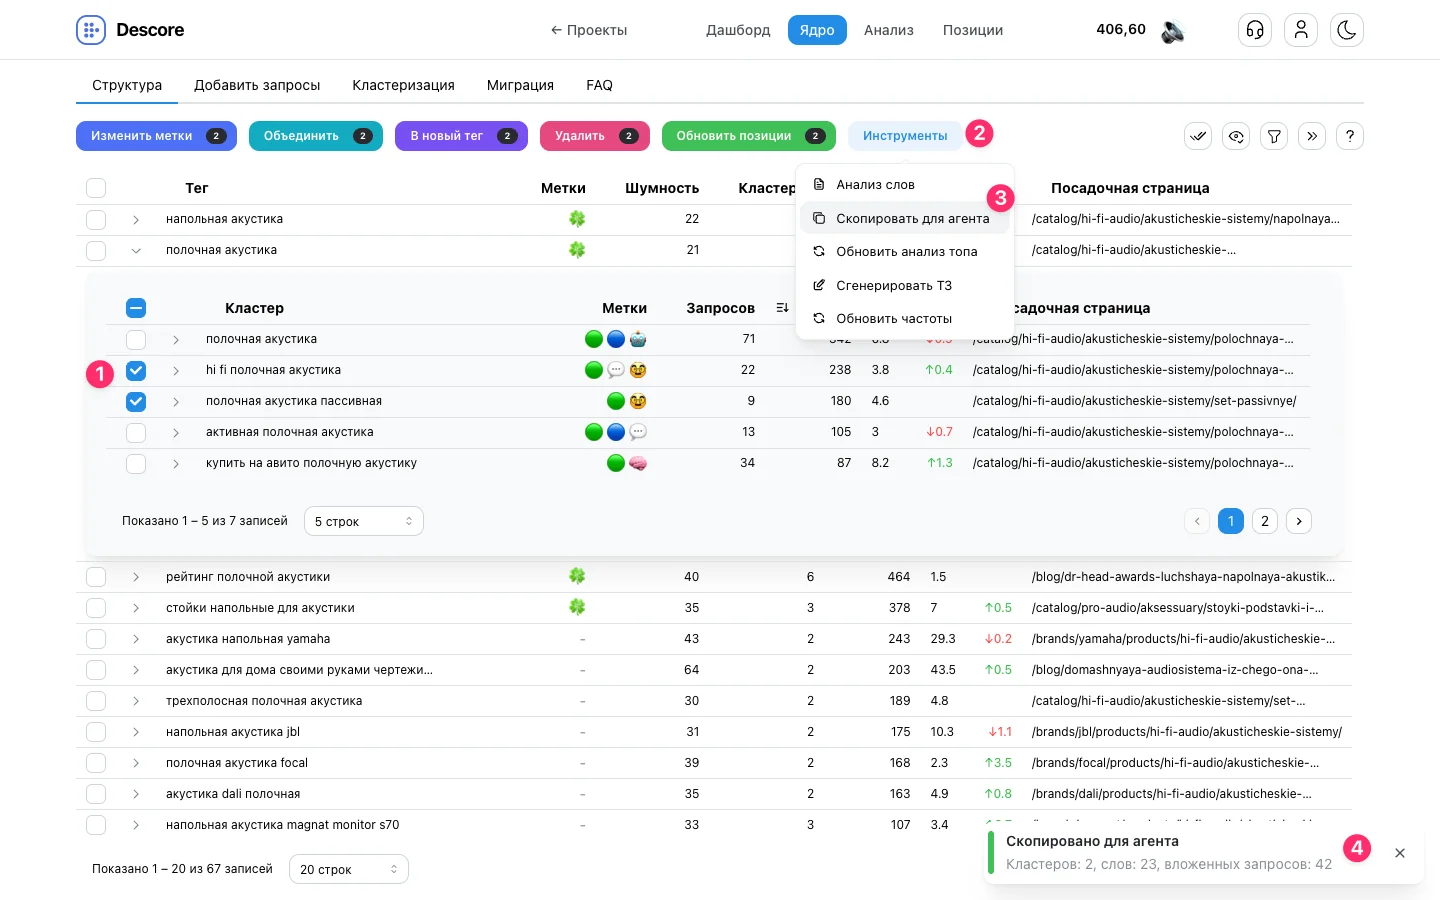
- 1 Выбор кластеров в таблице — отметьте один или несколько кластеров (до 200 штук за раз). В примере выбраны кластеры «hi fi полочная акустика» и «полочная акустика пассивная».
- 2 Кнопка «Инструменты» в тулбаре — синяя кнопка на верхней панели действий открывает меню операций над выбранными строками.
- 3 Пункт меню «Скопировать для агента» — агрегирует лексику входящих запросов по каждому выбранному кластеру и отправляет структурированный текст в буфер обмена.
- 4 Всплывающее уведомление (toast) — в правом нижнем углу появляется сообщение с подробной статистикой операции: количество обработанных кластеров, суммарное число лексем и общее количество вложенных запросов-примеров (например: «Кластеров: 2, слов: 23, вложенных запросов: 42»).
Формат данных в буфере: для каждого кластера формируется строка с URL в markdown-формате, названием кластера, суммарным спросом Wordstat и массивом лексем (до 3 наиболее частотных запросов на каждое слово):
[https://example.com/catalog/polochnaya-akustika/](https://example.com/catalog/polochnaya-akustika/) hi fi полочная акустика (суммарная частота: 1420): [{"слово":"акустика","частота":1420,"запросы":["hi fi полочная акустика","купить полочную акустику hi fi"]},{"слово":"полочный","частота":1420,"запросы":["hi fi полочная акустика","полочная акустика hifi"]},{"слово":"купить","частота":380,"запросы":["купить полочную акустику hi fi"]}]

[https://example.com/catalog/passivnaya-akustika/](https://example.com/catalog/passivnaya-akustika/) полочная акустика пассивная (суммарная частота: 640): [{"слово":"пассивный","частота":640,"запросы":["полочная акустика пассивная","пассивные полочные колонки"]},{"слово":"акустика","частота":640,"запросы":["полочная акустика пассивная"]}]
Если у кластера в Descore ещё не привязана целевая посадочная страница, вместо URL автоматически указывается заглушка URL не определён. Кластеры отделяются друг от друга двойным переносом строки.
Вариант 2. Точечный лексический срез (изнутри, из модального окна анализа слов)
Если требуется подготовить контекст не по всему кластеру целиком, а только по отдельным смысловым маркерам, откройте инструмент «Анализ слов» (кнопка в панели тега или пункт меню кластера).
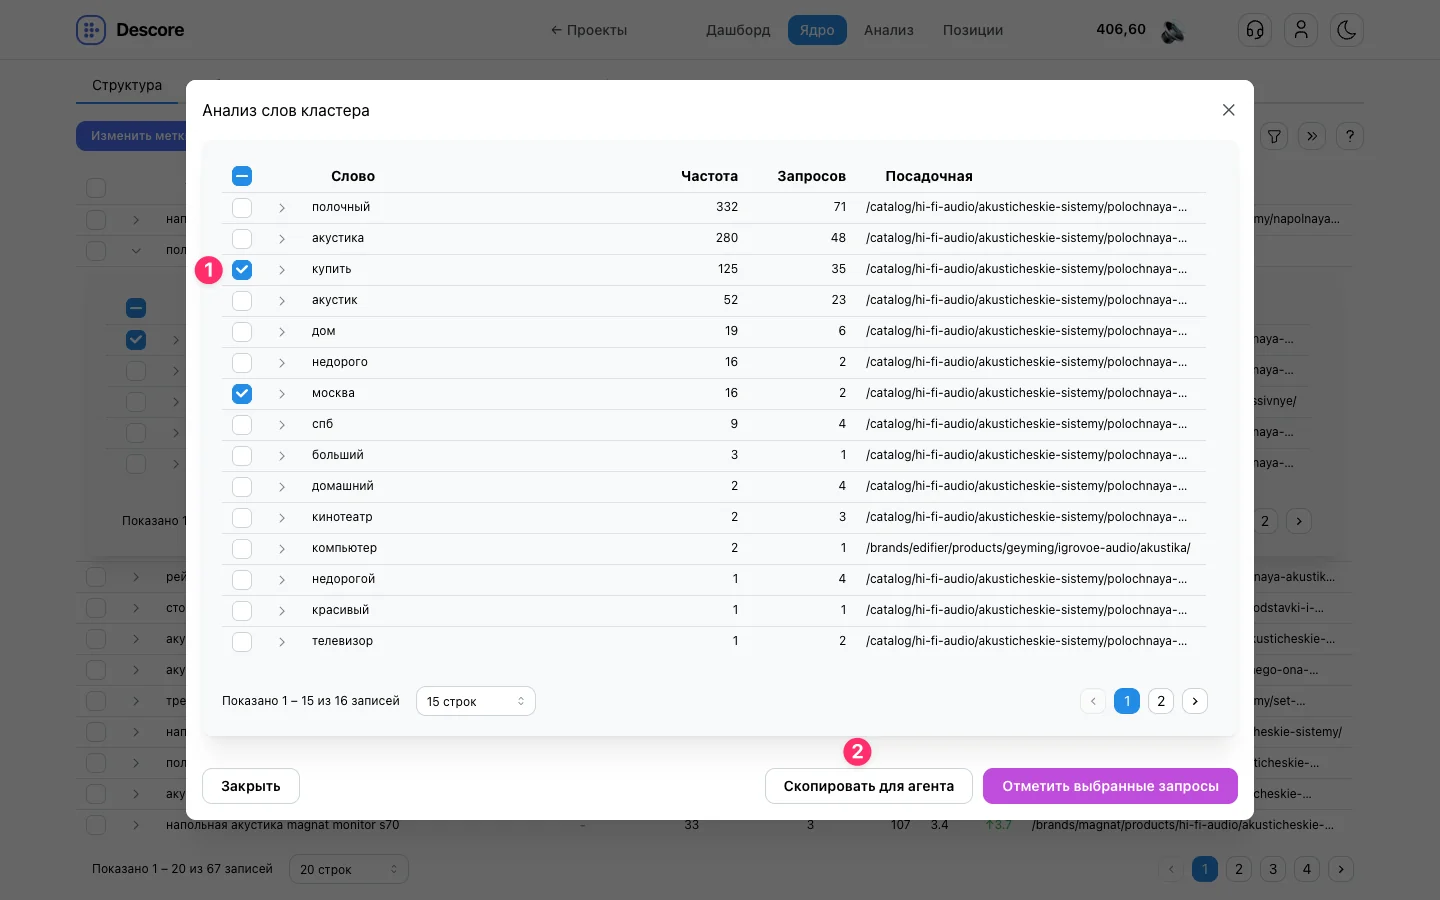
- 1 Выбор целевых лексем чекбоксами — в частотном словаре модального окна отметьте только те слова, которые требуется передать в нейросеть. В примере выбраны коммерческий маркер «купить» (частотность 125, 35 запросов) и гео-маркер «москва» (частотность 16, 2 запроса). При необходимости можно нажать на стрелку слева от слова, раскрыть подтаблицу запросов и отметить конкретные фразы.
- 2 Кнопка «Скопировать для агента» в подвале окна — расположена в правой части нижней панели, слева от фиолетовой кнопки отметки запросов (кнопка «Закрыть» находится слева). Кнопка активна, когда в таблице выбрано хотя бы одно слово.
Формат данных в буфере: в буфер обмена копируется чистый JSON-массив объектов без лишнего обрамления, готовый к парсингу скриптами или подаче в промпт LLM:
[
  {
    "слово": "купить",
    "частота": 125,
    "запросы": [
      "hi fi полочная акустика купить",
      "купить полочную пассивную акустику hi fi",
      "полочные колонки купить"
    ]
  },
  {
    "слово": "москва",
    "частота": 16,
    "запросы": [
      "hi fi полочная акустика купить в москве",
      "полочная акустика магазин москва"
    ]
  }
]
После нажатия кнопки модальное окно закрывается, а в правом нижнем углу появляется уведомление: «Скопировано: Слов: 2, вложенных запросов: 5» (если запросы в подтаблице не отмечались индивидуально, список запросов будет пустым, а счётчик покажет 0).
Сравнение формата данных в буфере обмена
Ключевые различия обоих способов:
| Параметр | Вариант 1 (снаружи, таблица структуры) | Вариант 2 (изнутри, анализ слов) |
|---|---|---|
Точка входа | Меню «Инструменты» над таблицей кластеров | Правая часть нижней панели окна «Анализ слов» |
Что попадает в буфер | URL страницы + имя кластера + сумма частот + частотный словарь лексем (до 3 примеров фраз на слово) | Чистый JSON-массив только отмеченных пользователем лексем и фраз |
Лимит элементов | До 200 кластеров за один раз (до 5 млн символов) | До 500 топовых лексем модального окна (выборка до 10 000 ключей) |
Основное назначение | Генерация Title/Description/H1, ТЗ на посадочную, аудит кластера | Точечная LSI-оптимизация, внедрение коммерческих маркеров |
Поведение окна | Остаётся на текущей таблице, показывает всплывающий тост | Копирует данные, очищает выборку и закрывает модальное окно |
Стоимость | Бесплатно (в рамках суточной квоты анализа слов проекта) | Бесплатно (данные уже загружены в модальное окно) |
Практические промпты для работы с нейросетями
Скопированные данные достаточно вставить в диалог с нейросетью вместе с готовой инструкцией. Ниже приведены 3 проверенных шаблона для повседневных SEO-задач:
Промпт 1. Пакетная генерация метатегов Title, Description и H1 (по данным Варианта 1):
Ты — ведущий SEO-специалист и редактор интернет-магазина.
Ниже приведён кластерный контекст посадочных страниц из системы Descore. Для каждого кластера указан целевой URL, название, суммарная частотность и словарь лексем с поисковыми фразами.

Твоя задача — составить для каждой страницы:
1. Заголовок H1 (краткий, естественный, 3-6 слов, включает главную частотную основу).
2. Тег Title (до 65-70 символов, максимальная концентрация главного ключа в начале, коммерческий хвост, бренд в конце).
3. Метатег Description (до 150-170 символов, сжатое УТП, призыв к действию, органичное вхождение дополнительных частотных лексем).

Требования: избегай переспама, согласуй падежи, пиши для людей.
Данные кластеров:
[ВСТАВИТЬ ДАННЫЕ ИЗ БУФЕРА ОБМЕНА]
Промпт 2. Составление ТЗ для копирайтера на посадочную страницу категории (по данным Варианта 1):
На основе приведённого контекста кластера составь подробное техническое задание копирайтеру на написание текста для посадочной страницы категории.

В ТЗ включи:
- Рекомендуемый объём текста (на основе семантического веса).
- Рекомендуемую структуру заголовков H2-H3.
- Список обязательных ключевых фраз в точной и разбавленной форме.
- Список околоцелевых LSI-слов, которые автор обязан упомянуть в теле статьи.
- Запрещённые стоп-слова и антипаттерны (вода, канцеляризмы).

Контекст кластера:
[ВСТАВИТЬ ДАННЫЕ ИЗ БУФЕРА ОБМЕНА]
Промпт 3. Точечное внедрение LSI-лексем в существующий текст (по данным Варианта 2):
У меня есть готовый текст описания категории/товара. Мне нужно органично доработать его, внедрив ключевые лексемы и фразы из семантического анализа Descore без потери качества и читаемости.

Вот список лексем и поисковых фраз, которые необходимо распределить по тексту:
[ВСТАВИТЬ JSON ИЗ МОДАЛЬНОГО ОКНА АНАЛИЗА СЛОВ]

Вот текущий исходный текст:
[ВСТАВИТЬ ВАШ ТЕКУЩИЙ ТЕКСТ]

Верни обновлённый текст, выделив добавленные фрагменты жирным шрифтом, и приложи краткий отчёт о том, в какие абзацы были добавлены ключевые слова.
Вопросы и ответы
В чём главное отличие копирования снаружи (из таблицы) и внутри (из анализа слов)?
Снаружи (в меню «Инструменты» таблицы структуры): копируется посадочный контекст выбранных кластеров — URL страницы, название кластера, общая частотность и частотный словарь лексем с примерами до 3 топовых входящих запросов на каждое слово.
Внутри (в модальном окне «Анализ слов»): формируется компактный JSON-массив только отмеченных пользователем слов-лексем и выбранных фраз. Это точечный срез для LSI-доработки текста или внедрения коммерческих маркеров.
Сколько кластеров можно скопировать за один раз?
В меню «Инструменты» кластеров действует ограничение до 200 кластеров за одну операцию и общий лимит объёма буфера до 5 000 000 символов. Если выбрать более 200 кластеров, пункт меню станет неактивным с подсказкой о необходимости сузить выборку.
Если в модальном окне не раскрывать запросы внутри слова, что скопируется?
Если чекбокс слова отмечен, а запросы внутри него не выбирались индивидуально через подтаблицу, выгружается объект с леммой, её суммарной частотностью и пустым списком "запросы": [] (в уведомлении будет 0 вложенных запросов). Если раскрыть слово и отметить конкретные ключи — в массив попадут ровно выбранные поисковые фразы.
Платная ли функция копирования для агента?
Операция бесплатна: она не требует списания баланса и не расходует платные лимиты проекта (проверки позиций). При пакетной выгрузке кластеров учитывается только стандартная суточная квота проекта на анализ слов (до 200 000 запросов в день).
Какие ИИ-модели лучше всего воспринимают сформированный контекст?
Формат подходит для любых современных LLM и агентских сред (ChatGPT, Claude, Gemini, Cursor, Aider). Чёткая структура «слово — частота — фразы» помогает модели опираться на реальный семантический вес ключей и снижает риск появления выдуманных поисковых форм.
Смотрите также
- Руководство: Структура — кластеры — групповые операции с кластерами, управление посадочными страницами и лимиты.
- Анализ слов тега и кластеров — подробный разбор работы морфологического анализатора, лемматизации и выгрузки лексем.
- Структура: запросы — управление запросами внутри кластеров, перенос фраз и съём позиций.
- Как быстро почистить шумную семантику — практический сценарий очистки ядра по показателю шумности.